|
数据类型
|
描述
|
|
__m128
|
包含4个float类型数字的向量
|
|
__m128d
|
包含2个double类型数字的向量
|
|
__m128i
|
包含若干个整型数字的向量
|
|
__m256
|
包含8个float类型数字的向量
|
|
__m256d
|
包含4个double类型数字的向量
|
|
__m256i
|
包含若干个整型数字的向量
|
-
每一种类型,从2个下划线开头,接一个m,然后是vector的位长度。
-
如果向量类型是以d结束的,那么向量里面是double类型的数字。如果没有后缀,就代表向量只包含float类型的数字。
-
整形的向量可以包含各种类型的整形数,例如char,short,unsigned long long。也就是说,__m256i可以包含32个char,16个short类型,8个int类型,4个long类型。这些整形数可以是有符号类型也可以是无符号类型。
_mm<bit_width>_<name>_<data_type>
-
<bit_width>
表明了向量的位长度,对于128位的向量,这个参数为空,对于256位的向量,这个参数为256。
-
<name>
描述了内联函数的算术操作。
-
<data_type>
标识函数主参数的数据类型。
-ps 包含float类型的向量
pd 包含double类型的向量
epi8/epi16/epi32/epi64 包含8位/16位/32位/64位的有符号整数
epu8/epu16/epu32/epu64 包含8位/16位/32位/64位的无符号整数
si128/si256 未指定的128位或者256位向量
m128/m128i/m128d/m256/m256i/m256d 当输入向量类型与返回向量的类型不同时,标识输入向量类型
|
数据类型
|
描述
|
|
_mm256_setzero_ps/pd
|
返回一个全0的float类型的向量
|
|
_mm256_setzero_si256
|
返回一个全0的整形向量
|
|
_mm256_set1_ps/pd
|
用一个float类型的数填充向量
|
|
_mm256_set1_epi8/epi16/epi32/epi64x
|
用整形数填充向量
|
|
_mm256_set_ps/pd
|
用8个float或者4个double类型数字初始化向量
|
|
_mm256_set_epi8/epi16/epi32/epi64x
|
用一个整形数初始化向量
|
|
_mm256_set_m128/m128d/m128i
|
用2个128位的向量初始化一个256位向量
|
|
_mm256_setr_ps/pd
|
用8个float或者4个double的转置顺序初始化向量
|
|
_mm256_setr_epi8/epi16/epi32/epi64x
|
用若干个整形数的转置顺序初始化向量
|
|
数据类型
|
描述
|
|
_mm256_load_ps/pd
|
从对齐的内存地址加载浮点向量
|
|
_mm256_load_si256
|
从对齐的内存地址加载整形向量
|
|
_mm256_loadu_ps/pd
|
从未对齐的内存地址加载浮点向量
|
|
_mm256_loadu_si256
|
从未对齐的内存地址加载整形向量
|
|
_mm_maskload_ps/pd
|
根据掩码加载128位浮点向量的部分
|
|
_mm256_maskload_ps/pd
|
根据掩码加载256位浮点向量的部分
|
|
(2)_mm_maskload_epi32/64
|
根据掩码加载128位整形向量的部分
|
|
(2)_mm256_maskload_epi32/64
|
根据掩码加载256位整形向量的部分
|
最后2个函数前面有一个(2),代表这两个函数只在AVX2中支持。
|
数据类型
|
描述
|
|
_mm256_add_ps/pd
|
对两个浮点向量做加法
|
|
_mm256_sub_ps/pd
|
对两个浮点向量做减法
|
|
(2)_mm256_add_epi8/16/32/64
|
对两个整形向量做加法
|
|
(2)_mm256_sub_epi8/16/32/64
|
对两个整形向量做减法
|
|
(2)_mm256_adds_epi8/16 (2)_mm256_adds_epu8/16
|
两个整数向量相加且考虑内存饱和问题
|
|
(2)_mm256_subs_epi8/16 (2)_mm256_subs_epu8/16
|
两个整数向量相减且考虑内存饱和问题
|
|
_mm256_hadd_ps/pd
|
水平方向上对两个float类型向量做加法
|
|
_mm256_hsub_ps/pd
|
垂直方向上最两个float类型向量做减法
|
|
(2)_mm256_hadd_epi16/32
|
水平方向上对两个整形向量做加法
|
|
(2)_mm256_hsub_epi16/32
|
水平方向上最两个整形向量做减法
|
|
(2)_mm256_hadds_epi16
|
对两个包含short类型的向量做加法且考虑内存饱和的问题
|
|
(2)_mm256_hsubs_epi16
|
对两个包含short类型的向量做减法且考虑内存饱和的问题
|
|
_mm256_addsub_ps/pd
|
加上和减去两个float类型的向量
|
将饱和度考虑在内的函数将结果钳制到可以存储的最小/最大值。没有饱和的函数在饱和发生时忽略内存问题。
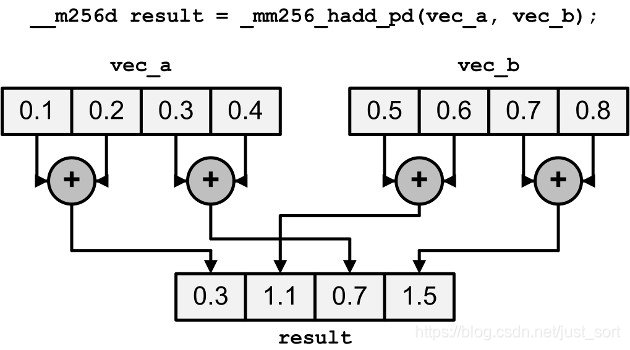
而在水平方向上做加减法的意思如下图:
 最后一个指令:
_mm256_addsub_ps/pd
在偶数位置减去,奇数位置加上,获最后得目标向量。
|
数据类型
|
描述
|
|
_mm256_mul_ps/pd
|
对两个float类型的向量进行相乘
|
|
(2)_mm256_mul_epi32 (2)_mm256_mul_epu32
|
将包含32位整数的向量的最低四个元素相乘
|
|
(2)_mm256_mullo_epi16/32
|
Multiply integers and store low halves
|
|
(2)_mm256_mulhi_epi16 (2)_mm256_mulhi_epu16
|
Multiply integers and store high halves
|
|
(2)_mm256_mulhrs_epi16
|
Multiply 16-bit elements to form 32-bit elements
|
|
_mm256_div_ps/pd
|
对两个float类型的向量进行想除
|
|
数据类型
|
描述
|
|
(2)_mm_fmadd_ps/pd/ (2)_mm256_fmadd_ps/pd
|
将两个向量相乘,再将积加上第三个。(res=a*b+c)
|
|
(2)_mm_fmsub_ps/pd/ (2)_mm256_fmsub_ps/pd
|
将两个向量相乘,然后从乘积中减去一个向量。(res=a*b-c)
|
|
(2)_mm_fmadd_ss/sd
|
将向量中最低的元素相乘并相加(res[0]=a[0]*b[0]+c[0])
|
|
(2)_mm_fmsub_ss/sd
|
将向量中最低的元素相乘并相减(res[0]=a[0]*b[0]-c[0])
|
|
(2)_mm_fnmadd_ps/pd (2)_mm256_fnmadd_ps/pd
|
将两个向量相乘,并将负积加到第三个。(res = -(a * b) + c)
|
|
(2)_mm_fnmsub_ps/pd/ (2)_mm256_fnmsub_ps/pd
|
将两个向量相乘,并将负积加到第三个 (res = -(a * b) - c)
|
|
(2)_mm_fnmadd_ss/sd
|
将两个向量的低位相乘,并将负积加到第三个向量的低位。(res[0] = -(a[0] * b[0]) + c[0])
|
|
(2)_mm_fnmsub_ss/sd
|
将最低的元素相乘,并从求反的积中减去第三个向量的最低元素。(res[0] = -(a[0] * b[0]) - c[0])
|
|
(2)_mm_fmaddsub_ps/pd/ (2)_mm256_fmaddsub_ps/pd
|
将两个矢量相乘,然后从乘积中交替加上和减去(res=a*b+/-c)
|
|
(2)_mm_fmsubadd_ps/pd/ (2)_mmf256_fmsubadd_ps/pd
|
将两个向量相乘,然后从乘积中交替地进行减法和加法(res=a*b-/+c)(奇数次方,偶数次方)
|
|
数据类型
|
描述
|
|
_mm_permute_ps/pd _mm256_permute_ps/pd
|
根据8位控制值从输入向量中选择元素
|
|
(2)_mm256_permute4x64_pd/ (2)_mm256_permute4x64_epi64
|
根据8位控制值从输入向量中选择64位元素
|
|
_mm256_permute2f128_ps/pd
|
基于8位控制值从两个输入向量中选择128位块
|
|
_mm256_permute2f128_si256
|
基于8位控制值从两个输入向量中选择128位块
|
|
_mm_permutevar_ps/pd _mm256_permutevar_ps/pd
|
根据整数向量中的位从输入向量中选择元素
|
|
(2)_mm256_permutevar8x32_ps (2)_mm256_permutevar8x32_epi32
|
使用整数向量中的索引选择32位元素(浮点和整数)
|
|
数据类型
|
描述
|
|
_mm256_shuffle_ps/pd
|
根据8位值选择浮点元素
|
|
_mm256_shuffle_epi8/ _mm256_shuffle_epi32
|
根据8位值选择整数元素
|
|
(2)_mm256_shufflelo_epi16/ (2)_mm256_shufflehi_epi16
|
基于8位控制值从两个输入向量中选择128位块
|
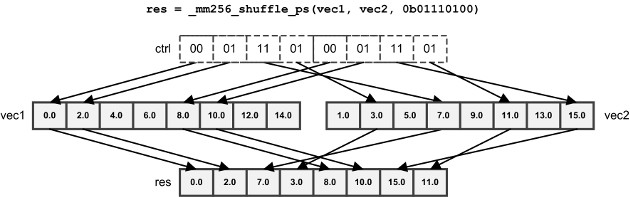
对于_mm256_shuffle_pd,只使用控制值的高4位。如果输入向量包含int或float,则使用所有控制位。对于_mm256_shuffle_ps,前两对位从第一个矢量中选择元素,第二对位从第二个矢量中选择元素。
https://blog.triplez.cn/avx-avx2-learning-notes/
AVX编程基础数据类型数据类型描述__m128包含4个float类型数字的向量__m128d包含2个double类型数字的向量__m128i包含若干个整型数字的向量__m256包含8个float类型数字的向量__m256d包含4个double类型数字的向量__m256i包含若干个整型数字的向量每一种类型,从2个下划线开头,接...
fast-utf8-validator该库是使用
AVX
2 / SSE4
指令
的非常快速的UTF-8验证器。
据我所知,它是支持这些
指令
的CPU上世界上最快的验证器(...而不是
AVX
-512)。
使用更快的utf8验证器该库是使用
AVX
2 / SSE4
指令
的非常快速的UTF-8验证器。
据我所知,它是支持这些
指令
的CPU上世界上最快的验证器(...而不是
AVX
-512)。
使用
AVX
2,它可以以高达0.26个周期/字节的速度验证随机UTF-8文本,并以.09个周期/字节的速度验证随机ASCII文本。
对于UTF-8,这大约比fastvalidate-utf-8库快1.5-1.7倍。
该存储库包含库(一个C文件),这是make的构建脚本。
因为最近在做SSE/
AVX
指令
集优化视频编码的某些模块,所以要
学习
SSE
指令
集的用法。本帖主要记录本人用到的函数的用法,将会持续更新下去。
一、SSE
指令
(128位寄存器)
__m128i _mm_load_si128 (__m128i *p);
MOVDQA
将p加载到128位寄存器上,比如p指针指向int类型(32位),则取出4个值加载到寄存器上。必须是16字节对齐方式。
__m12...
__m256i
包含若干个整型数据的向量,如char、short、int、unsigned long long等。例如256位的vector可以32个char、16个short、8个int,这些整型既可以是有符号的也可以是无符号的。
SIMD 一条
指令
可以执行多个数据group的计算和输出。对于SIMD相对应的SISD.
intel
SSE2 ,
AVX
2,
AVX
-512
假设有一个任务是统计字符串中每一个字符出现的次数,我们可以用128bit 的SISD
指令
进行统计。每8个bit代表一个字符,所以只需要两个SIMD
指令
(move mask、pop count)。
详细测试:
#include <stdio.h>
#include <thread>
#define INC_TO 1000000 // o
OS: win10 和 centos7,其他的linux应该都差不多。(参考这篇文章,作者也在ubuntu18.04以及Archlinux上进行过对应的测试均可)
gcc: 如果使用
AVX
指令
集在编写cmake或者makefile文件时需要加上 -m
avx
2 参数。低版本的gcc 不支持 -m
avx
2 参数,具体是在哪个版本加进来的不知道,试试就知道了。
CPU: 其实处理器也需要支持这个
指令
集,比如
avx
512需要
Intel
四代之后才有,可以去对应厂家的官网上查询,或者直接跑代码,看下耗时。SIMD的相
从2011年的Sandy Bridge微架构处理器开始,现在支持
AVX
系列
指令
集的处理器越来越多了。本文探讨如何用VC编写检测
AVX
系列
指令
集的程序,并利用了先前的CPUIDFIELD方案。
一、
AVX
系列
指令
集简介
SSE5
指令
:SSE5 是一个纸面上的
指令
集,并没有最终实现,AMD 在 2007 年 8 月公布 SSE5
指令
集规范,在 2009 年 5 月 AMD 推出了 XOP,...
在
Intel
Sandy Bridge微架构中,
Intel
引入了256位SIMD扩展
AVX
,这套
指令
集在兼容原MMX、SSE、SSE2对128位整点SIMD支持的基础上,把支持的总向量数据宽度扩展成了256位。新增了若干条256位浮点SIMD
指令
。
昨天,
Intel
刚刚发布了
AVX
2
指令
集,这套
指令
集在
AVX
基础上做了扩展,不过要在2013年发布的Haswell处理器上才能支持。参考1给出了
列名解释——
GCC470:GCC 4.7.0 (Fedora 17)。/usr/lib/gcc/i686-redhat-linux/4.7.0/include/。
GCC462:GCC 4.6.2 (MinGW)。\lib\gcc\mingw32\4.6.2\include。
宏:判断该
指令
集是否启用的宏。
参数:启用该
指令
集的命令行参数。
描述:
指令
集描...
来自于《
Intel
汇编语言程序设计》(第四版)第八章,该过程返回字符串长度到EAX寄存器中,调用该过程时需要传递字符串的偏移,如:
INVOKE Str_length,ADDR myString
Str_length过程代码如下:
Str_length PROC USES edi,
pString : PTR BYTE ;...
如果是_mm256_insert_epi32函数问题,那可添加如下代码即可
#if _MSC_VER <= 1900
#define _mm256_insert_epi16(a, d, indx) \
_mm256_inser