


前端Array.prototype.sort学习 + 了解原理
前言
在看
vue
的任务调度这块遇到了这个
Array.prototype.sort
方法,之前因为面试有了解过,但是不多。。。今天咱来复习下用法以及了解下原理
timsort代码
我给放到github上了
git clone https://github.com/1714080902120/tim_sort_study.git拉下来即可。
基础
相信大家之前都有用过,不过为了加深印象,这里还是说下。
语法 [1]
// Functionless
sort()
// Arrow function
sort((a, b) => { /* … */ } )
// Compare function
sort(compareFn)
// Inline compare function
sort(function compareFn(a, b) { /* … */ })
-
compareFn:一个函数用于指定排序的顺序。可选。如果忽略,数组的元素会转换为字符串类型,然后根据每个字符的统一Unicode编码值来排序。默认是从小到大递增排序。 下面统一叫做比对函数。 -
a:比对函数中第一个元素。 -
b:比对函数中第二个元素。
返回值
返回排序后的原数组的引用,这就意味着这个
api
是会影响到数组自身的。
例子
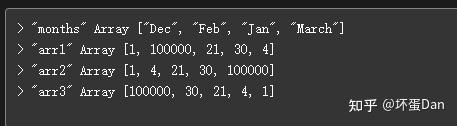
const months = ['March', 'Jan', 'Feb', 'Dec'];
months.sort();
console.log('months', months);
// Expected output: Array ["Dec", "Feb", "Jan", "March"]
const array1 = [1, 30, 4, 21, 100000];
array1.sort();
console.log('arr1', array1);
// Expected output: Array [1, 100000, 21, 30, 4]
const arr2 = [1, 30, 4, 21, 100000];
arr2.sort((a, b) => (a - b));
console.log('arr2', arr2);
// Expected output: Array [1, 4, 21, 30, 100000]
const arr3 = [1, 30, 4, 21, 100000];
arr3.sort((a, b) => (b - a));
console.log('arr3', arr3);
// Expected output: Array [100000, 30, 21, 4, 1]
对应输出

如果元素是对象,可根据自身需要定制,比如:
const items = [
{ name: "Edward", value: 21 },
{ name: "Sharpe", value: 37 },
{ name: "And", value: 45 },
{ name: "The", value: -12 },
{ name: "Magnetic", value: 13 },
{ name: "Zeros", value: 37 },
// sort by value
items.sort((a, b) => a.value - b.value);
// sort by name
items.sort((
a, b) => {
const nameA = a.name.toUpperCase(); // ignore upper and lowercase
const nameB = b.name.toUpperCase(); // ignore upper and lowercase
if (nameA < nameB) {
return -1;
if (nameA > nameB) {
return 1;
// names must be equal
return 0;

说明 [2]
如果没有提供比对函数,那么所有
非
undefined
数组元素会被转换成字符串类型。然后将根据这些字符串的
UTF-16
统一编码值来排序。

因为
banana
的第一个字符
b
的值是
98
,
cherry
的第一个字符
c
是
99
,所以这里判断到
c
小于
b
就将
banana
排到
cherry
前面去了。

再举个例子:如果是按数字排序
9
一定是排在
80
之前的。但是如果是字符串,
'9'
和
'80'
就不一样了。
'80'
会被分为两个字符
'8'
和
'0'
,所以
'8'
和
'9'
比自然是
'8'
排在前面。当然,
'80'
和
'8'
对比的话,
'8'
还是会在
'80'
前面。
另外
sort
方法会保留空(包括
undefined
)元素,如果存在,则会把它们移动到数组后面。
比如:

需要注意,在
UTF-16
中,如果字符编码超出了
\uFFFF
,那么就会被编码成两个代理项单元(
surrogate code unit
),范围是
\uD800 - \uDFFF
。而在我们的比对过程中,这两个单元是独立的,因此,字符编码是
\uD855\uDE51
的会排到
\uFF3A
前面。
如果我们提供了对比函数,那么所有
非
undefined
的元素都会根据我们函数提供的返回值来排序。而所有
undefined
的元素依旧会被移动到数组的后面。它们不会参与比对,也不会被传入到比对函数中。

根据对比函数的返回值,前后两个元素会有不同的排序结果。
-
> 0:a会在b后面。 -
< 0:a会在b前面。 -
=== 0:保持原来的排序。
来看下例子

你可能会有些疑惑为什么排序的顺序不对,别急,等会会说到。
大部分情况下,为了确保正确的顺序,比对器(
comparator
)会有下面几个属性:
-
Pure:比对器不会修改用于比对的对象或者任何内部的状态。(这相当重要,因为并不能保证比对器会在哪里被调用)。 -
Stable:类似纯函数,输出和输入的内容挂钩,传入同样的数据一定会得到同样的结果。 -
Reflexive:compareFn(a, a) === 0。 -
Anti-symmetric:compareFn(a, b)和compareFn(b, a)的结果要么为0,要么相反。 -
Transitive:如果compareFn(a, b)和compareFn(b, c)都是positive、zero、negative,那么compareFn(a, c)也会有同样的结果。
一个满足上面几个属性的比对器可以返回
1, 0, -1
或者连续的
0
。比如,如果一个比对器值返回
1
和
0
,或者只返回
0, -1
,那么这个比对的顺序将无法被保证,因为破坏了
anti-symmetry
属性。一个比对器如果一直返回
0
将导致数组的顺序不会发生变化,虽然结果可能是对的。
默认的比对器是完全满足上面所说的属性的。
另外,
NaN
会被用于比对,但是这个数自身不能用于比对,那么这时就会有问题了。

还有
Infinity
,它用于表示无穷大。如果它出现在数组中,也会用于比对,但是它的位置会被放到最前面/最后面。
不同场景的例子
基本用法
const stringArray = ["Blue", "Humpback", "Beluga"];
const numberArray = [40, 1, 5, 200];
const numericStringArray = ["80", "9", "700"];
const mixedNumericArray = ["80", "9", "700", 40, 1, 5, 200];
function compareNumbers(a, b) {
return a - b;
stringArray.join(); // 'Blue,Humpback,Beluga'
stringArray.sort(); // ['Beluga', 'Blue', 'Humpback']
numberArray.join(); // '40,1,5,200'
numberArray.sort(); // [1, 200, 40, 5]
numberArray.sort(compareNumbers);
// [1, 5, 40, 200]
numericStringArray.join(); // '80,9,700'
numericStringArray.sort(); // ['700', '80', '9']
numericStringArray.sort(compareNumbers); // ['9', '80', '700']
mixedNumericArray.join(); // '80,9,700,40,1,5,200'
mixedNumericArray.sort(); // [1, 200, 40, 5, '700', '80', '9']
mixedNumericArray.sort(compareNumbers); // [1, 5, '9', 40, '80', 200, '700']
Array<Object>数组对象结构
const items = [
  { name: "Edward", value: 21 },
  { name: "Sharpe", value: 37 },
  { name: "And", value: 45 },
  { name: "The", value: -12 },
  { name: "Magnetic", value: 13 },
  { name: "Zeros", value: 37 },
// sort by value
items.sort((a, b) => a.value - b.value);
// sort by name
items.sort((a, b) => {
  const nameA = a.name.toUpperCase(); // ignore upper and lowercase
  const nameB = b.name.toUpperCase(); // ignore upper and lowercase
  if (nameA < nameB) {
    return -1;
  if (nameA > nameB) {
    return 1;
  // names must be equal
  return 0;
非
ASCⅡ
字符比较
由于并非所有字符都是
ASCⅡ
字符,比如
(e, é, è, a, ä)
,所以可能会有遇到非
ASCⅡ
比较顺序不符合预期的问题。这个时候我们可以搭配
String.prototype.localeCompare()
。这个
api
会返回一个数字,正好和
compareFn
的作用差不多。
const items = ["réservé", "premier", "communiqué", "café", "adieu", "éclair"];
items.sort((a, b) => a.localeCompare(b));
// items is ['adieu', 'café', 'communiqué', 'éclair', 'premier', 'réservé']
搭配
map
由于数组中每个元素可能调用多次
compareFn
,所以随着数组的元素个数增长,性能损耗也会增高。
如果你还在排序的过程中做别的操作,那么损耗就很进一步上升。
为了减少损耗,我们可以搭配
map
来排序。原理是先遍历这个数组一次,抽取实际排序的元素,将它们放到一个临时数组里。排序这个临时数组。然后再遍历这个临时数组获得正确的顺序。
// the array to be sorted
const data = ["delta", "alpha", "charlie", "bravo"];
// temporary array holds objects with position and sort-value
const mapped = data.map((v, i) => {
  return { i, value: someSlowOperation(v) };
// sorting the mapped array containing the reduced values
mapped.sort((a, b) => {
  if (a.value > b.value) {
    return 1;
  if (a.value < b.value) {
    return -1;
  return 0;
const result = mapped.map((v) => data[v.i]);
这里还有一个开源的库可以用,感兴趣的大佬可以自行去看下: mapsort 。
稳定性 [3]
从
version 10
也就是
ECMA2019
开始,
Array.prototype.sort
是稳定的了。具体可以看:
https://
tc39.es/ecma262/#
sec-array.prototype.sort
比如,如果你有一组学生的成绩和名字,假设现在已经是按照名字排序过了的。
const students = [
  { name: "Alex", grade: 15 },
  { name: "Devlin", grade: 15 },
  { name: "Eagle", grade: 13 },
  { name: "Sam", grade: 14 },
然后我们根据成绩来排序
students.sort((firstItem, secondItem) => firstItem.grade - secondItem.grade);
结果将变成这样
[
  { name: "Eagle", grade: 13 },
  { name: "Sam", grade: 14 },
  { name: "Alex", grade: 15 }, // original maintained for similar grade (stable sorting)
  { name: "Devlin", grade: 15 }, // original maintained for similar grade (stable sorting)
其中
Alex
和
Devlin
的由于成绩一样,所以它俩的顺序依旧和之前一样
Alex
在前而
Devlin
在后。
而在
version 10
之前,它的顺序会变成如下
[
  { name: "Eagle", grade: 13 },
  { name: "Sam", grade: 14 },
  { name: "Devlin", grade: 15 }, // original order not maintained
  { name: "Alex", grade: 15 }, // original order not maintained
并没有完全保证顺序的正确。
使用不正确的比较器来排序
如果比较器的函数不满足上面提到的几个属性
pure、stable、reflexive、anti-symmetry
以及
transitivity
,那么排序的结果可能会不符合预期。
比如:
const arr = [3, 1, 4, 1, 5, 9];
const compareFn = (a, b) => (a > b ? 1 : 0);
arr.sort(compareFn);
这个
compareFn
只包含
1
和
0
两种返回值,那么它就不满足
anti-symmetry
这个属性。
当
a < b
的时候,它应该返回一个负数,现在则是返回
0
。那么它的实际排序结果可能会不符合预期

这个火狐的
SpideMonkey
里面的表现则是
[1, 1, 3, 4, 5, 9]
。
然而,如果我们把
1
变成
-1
,那么实际结果又会有不同。
在基于
V8
或者
JavaScriptCore
的表现则是正常的
[9, 5, 4, 3, 1, 1]
,而在
SpiderMonkey
里则是返回
[3, 1, 4, 1, 5, 9]
。
那么这就有可能造成很严重的
bug
了,所以为了避免这些场景,尽量满足上面的属性。
给非数组使用
sort
sort
方法会获取
this
的
length
属性。并且会收集所有已存在的整数键(
integer-keyed
)属性在
0 - length - 1
之间,然后给他们排序之后再写回。如果在这个范围内缺失了属性,它会删除对应的属性,就像不存在的元素都会被放到数组后后面一样。
const arrayLike = {
  length: 3,
  unrelated: "foo",
  0: 5,
  2: 4,
console.log(Array.prototype.sort.call(arrayLike));
// { '0': 4, '1': 5, length: 3, unrelated: 'foo' }
原理
它的底层原理实际上是基于[
in place
](
In-place algorithm - Wikipedia
)算法。
我们来看下这个算法的工作原理。
就地算法(
in-place algorithm
)
[4]
翻译过来叫做就地算法。。。
就地算法是一种不需要借助数据结构就可以转换输入内容的算法。当然,还是需要一点额外空间的,我们需要有辅助变量来实现这一过程。在执行的过程中,输入的内容一般都会被输出的内容重写。
就地算法通过替换(
replacement
)或者互换(
swapping
)元素来实现更新输入序列。如果一个算法不是就地算法,那么一般叫它们
not-in-place
或者
out-of-place
。
in-place
有特殊的意义。在它严格的格式下,算法所用的额外空间是常量(
constant amount of extra space
), 这些空间用于记录函数调用和指针(
pointers
)。然而,这种格式是非常局限的,因为简单的用索引表示函数的长度
n
需要的空间就是
O(log n)
bits。一般这个所用空间都是
O(log n)
,有时是
O(n)
,也是允许的。
这里有一点需要注意,空间复杂度(
space complexity
)在是否将所以长度记为所用空间的一部分方面也有不同的选择。一般情况下,空间复杂度都是根据索引的数字和指针的个数,而忽略的它们的长度。这里选择
DSPACE
,也就是选择总的空间复杂度,记录指针的长度。因此,于忽略索引和指针长度分析相比,这里还需要有额外的
log n
的空间。
in-place
一般不需要考虑
output
的空间,因为都是直接对
input
的操作处理。当将
output
写入
write-only
内存或者
stream
的时候,它更多的是考虑工作空间(
work space
)。
例子:
给出一个长度为
n
的数组,我们需要将这个数组倒序输出。
最常见的方法自然是创建一个新的数组,然后遍历原数组,将元素放入新数组中。
但是这里就需要使用到
O(n)
的额外空间,我们希望这个空间是一个常量。所以这里就可以用上前面提到的就地算法了。
我们只需要两个额外空间,一个是索引
i
,一个是临时变量,所用空间则是
O(2)
。
const arr = [1, 2, 3, 4, 5, 7];
function reverseArr(arr) {
  let a = 0;
  for (let i = 0; i < Math.floor((arr.length) / 2); i++) {
      a = arr[i];
      arr[i] = arr[arr.length - 1 - i];
      arr[arr.length - 1 - i] = a;
  return arr
console.log(reverseArr(arr));

就地算法最常见的地方是和各种排序算法搭配。比如冒泡排序(
bubble sort
)、组合排序(
comb sort
)、选择排序(
selection sort
)、插入排序(
insertion sort
)、堆排序(
heapsort
)以及希尔排序(
Shell sort
)。这些排序算法都只需要一些指针,所以它们的空间复杂度一般都是
O(log n)
。
快速排序(
Quicksort
)也是就地排序的,但是在它分而治之的策略下(
divide and conquer
)它需要
O(log n)
的堆空间指针,用于保持对子数组(
subarrays
)的跟踪。因此,快速排序所需要的空间复杂度为
O(log² n)
。尽管这非常量空间让快速排序被移除就地算法的分类下,快速排序和其它算法都仅需要
O(log n)
额外的指针空间致使它们还是被视作为就地算法。
那么原文档看到这里就差不多了,其它都是无关的了,我们的目标主要是基于就地算法的排序算法。
v8引擎使用的排序算法 [5] [6]
由于不同的浏览器对于这个
sort
方法都有自己的想法,所以上来并没有说具体是哪个排序算法,而是先说了下就地算法,因为虽然排序算法不同,但是也都是基于就地算法的。
我们这里就选择最广泛使用的
V8
引擎实现的
sort
来分析。
在
v8
的
v7.0
版本之前(
chrome 70
),
V8
引擎用的是插入排序 搭配 快排,少于
10
个元素的时候用插入,否则用快排。
但是快排是不稳定的,所以在
v7.0
版本之后,
v8
引擎采用的是
TimSort
的排序算法。

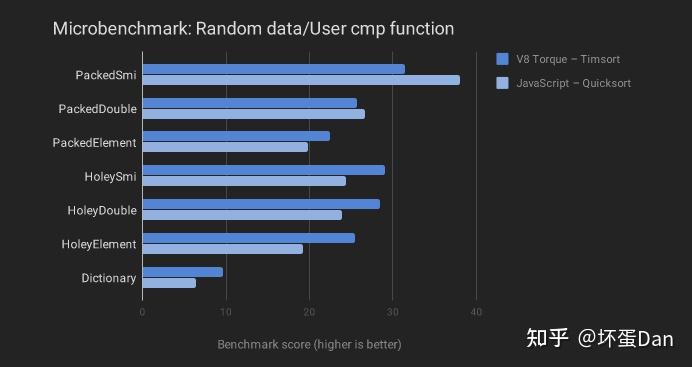
下面这张图则是有部分内容
sort
的情况下。

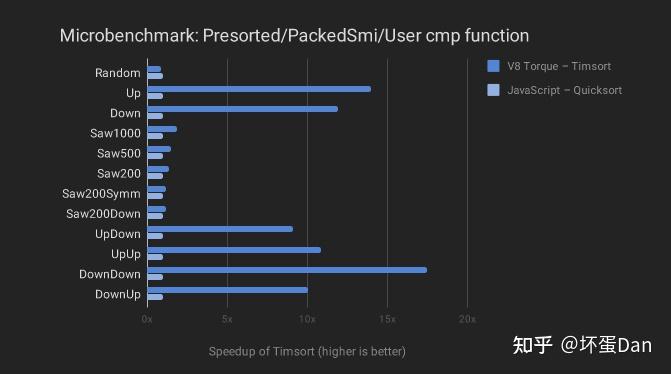
TimSort [7] [8]
timsort
算法最开始是由
Tim Peters
[9]
在
2002
年为
Python
开发的。
Timsort
最合适的描述是一种自适应稳定的归并排序(
Mergesort
)变体(
variant
)。
尽管其中的原理更加复杂,基础的理论是比较容易理解的。官方也有提供相关描述: the man himself 或者 Wikipedia page 。
归并排序一般是基于递归(
recursive
)的方式实现,而
Timsort
则是通过迭代(
iteratively
)的方式实现。
Timsort
会从左往右的处理数组,找到一个所谓的(
so-called
)的
runs
。一个
run
是简单的已经排序好了的序列。这里面包含一些
the wrong way
排序的子序列,它们可以通过简单的方式排序,比如倒序。
在分拣过程开始时,根据输入的长度确定最小运行长度。如果
Timsort
无法找到一个最小的运行长度,那么它将使用插入排序(
Insertion sort
)"人工增压"(
boosted artificially
)。
不过和归并排序不同的是,这里合并的
runs
的长度不是固定的,这么做的好处是合并的量不会太大,因而减少了比对的时间。
所以简单的说,这个算法最基础的理论实际上是插入排序 + 归并排序。
以这种方式找到的
run
会被栈跟踪,这个栈会记录开始的索引和每个
run
的长度。
每一次栈里面的
runs
都会合并到一起直到这里面只有一个
run
为止。
Timsort
尝试去维持一个平衡当它开始决定哪个
run
将被合并。
啥平衡呢?
一方面,我们希望能尽早的合并那些大概率已经在缓存中的
runs
,另一方面我们希望合并的尽量晚点以充分的利用可能出现在数据中的模式(
patterns
)。
为了实现这一点,
Timsort
维持了两个变体。
假设
A
、
B
和
C
是三个处于栈顶端的
run
。
需要始终满足下面两个变体:
-
|C| > |B| + |A| -
|B| > |A|

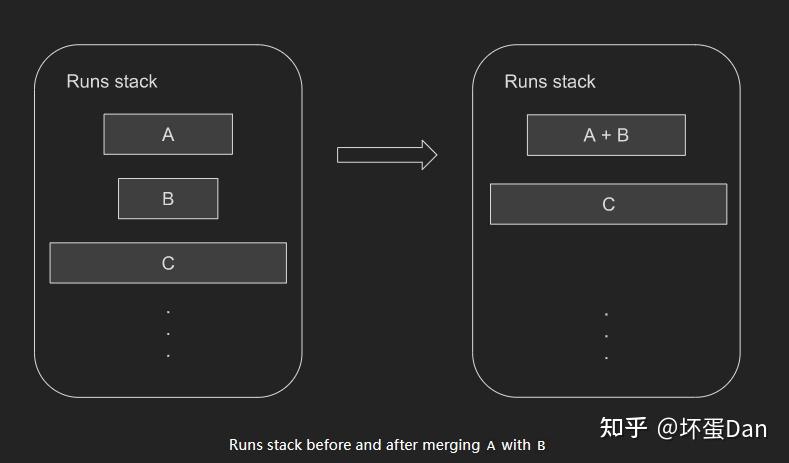
该图显示了
|A| > |B|
,不满足第二个变体,因此
B
与两个运行中较小的一个也就是
A
合并。
一旦这里满足了两个变体,下一次查找
run
的过程就开始了。
这里有一点需要注意,
Timsort
置灰合并连续的(
consecutive
)
runs
,这对于保证稳定性来说是必须的。否则,相等的元素将在多个
runs
之间转移。
第一个变体确保
run
的长度增长至少和斐波那契数列(
Fibonacci numbers
)一样快,当我们知道数组的最大长度时,给出栈的限制大小。
那么最好的情况的时间复杂度已经可以知道了,那就是只有一个
run
的时候,不需要合并,此时时间复杂度是
O(n)
。而最差的情况的时间复杂度是
O(n log n)
。
这些算法属性以及稳定性使得
v8
引擎放弃了快排选择了
Timsort
。
合并的空间复杂度
原来的归并排序实现是
not-in-place
的,它的空间复杂度是
O(N)
。有基于就地算法实现的归并排序,但是它时间上的损耗较高。
Timsort
结合了这两种情况,它的时间复杂度稍微超出了归并排序的时间复杂度,但是它的空间复杂度也降低到稍微超出了
O(N)
。
最初,
Timsort
采用二分查询(
binary search
)查找第二个
run
的第一个元素插入到第一个有序的
run
的位置,这样保持了它的有序。
然后,它采用相同的算法去查找第一个
run
的最后一个元素插入到第二个
run
里的位置,也保持了它的有序。
元素在这区间之外的都已经是排序好了的。
然后区间内的元素(两个
runs
剩余的未排序元素)会被放到一个临时内存空间里,然后合并成一个大一些的
run
。
如果第一个
run
比较小,那么合并的开始是从头开始,反之从后开始。这波操作减少了元素的移动,提高了性能。
举个栗子:
A
和
B
都已经排序完毕了。
A:
[1, 2, 3, 6, 10]
B:
[4, 5, 7, 9, 12, 14, 17]
他俩需要被
merge
。
B
的第一个元素
4
将会被插入到
A
的第四个位置,第四个位置就是通过二分查询找到的。
而
A
的最后一个元素是
10
,它将会被插入到
B
的第五个位置,这个位置也是通过二分查询找到的。
那么这个时候
[1, 2, 3]
和
[12, 14, 17]
都在区间外。
区间内的则是
[6, 10]
和
[4, 5, 7, 9]
。
那么我们现在需要用到的临时
buffer
就从
4
降低成
2
。
Merge的方向
merge
从左到右或者从又到左都可以。
合并期间的快速增加模式(
galloping mode
)
R1
和
R2
俩
run
的合并是独立的,这个过程中记录的选择的连续元素的个数是保留着的。
当这个数字达到了最小的增加阈值(
minimum galloping threshold(min_gallop)
).
Timsort
会将这视作还有很多连续的元素正准备被选择,然后切换到
galloping mode
。
让我们假设下
R1
负责触发它。在这种模式下,算法会变现为一个指数搜索(
exponential search
),也被叫做
galloping search
,用于查找
R1
中
R2
的下一个元素
x
。
通过两步来实现:
-
查找
x所在的范围(2^k - 1, 2^(k + 1) - 1)。 - 二分查询这个元素。
这个模式是一种尝试使合并算法在
run
元素之间适应的间隔模式(
pattern of intervals
)。
它并非一直都有效。在一些场景中快速增加模式需要做比线性搜索(
linear search
)更多的比较(
comparisons
)。
根据开发者做的
benchmarks
,仅当第一个
run
的初始元素不是另一个
run
前七个元素才有效。
这意味着初始的阈值是
7
。
为了避免这个问题,采纳了以下两个行为:
-
当
galloping查找效率比二分查询低的时候,galloping mode会中断。 -
失败或者成功的
galloping都会被用于矫正min_gallop。如果选择的元素是来自之前返回的元素所在的数组,min_gallop会减1, 否则增加1,减少/增加会慢慢使我们的合并算法回galloping mode。而对于随机数据来说,这个min_gallop会变得非常大导致无法回归galloping mode。
递降的
runs
(
Descending runs
)
为了充分利用递降的排序,
Timsort
会完全反转递降的
runs
当它发现了它们并且将它们加入到
runs stack
里面。
由于递降的
runs
会被直接反转,因此排除具有相同元素的
runs
可以保持算法的稳定性,即相等的元素不会被反转。
最小的
run
的
size
当runs的数量等于或者稍微小于二的幂(
a power of two
)的时候合并的效率是最高的,而当稍微大于二的幂的时候,效率会显著的减少。因此,Timsort选择最小
run(minrun)
用来确保合并效率。
minrun
是从
[32, 64]
范围之间选择出来的,而数据的大小会根据这个
minrun
分割,基本等于或者稍微小于二的幂次。
最终算法采用数组大小的六个最高有效位,如果设置了任何剩余位,则添加一个,并将该结果用于minrun。
这个算法适用于所有的数组,包括小于64的。对于大小为63或者更小的数组,这会将minrun设置为等于数组大小,并将Timsort简化为插入排序。

图里为最小的排序了的
run
。
分析(Analysis)
最坏的情况
Timsort
的时间复杂度是
O(nlogn)
,当数组全然无序的情况。
而最好的情况则是
O(n)
,传入的数组已经是排序完毕了的。
Timsort
再对对象或者指针进行排序的方面优于快排,因为快排需要昂贵的内存空间间接的寻址来访问数据和执行比较,使得快排的缓存一致性优势大大降低。
实现Timsort
前面说了这么多,感觉头都晕了,不如直接上代码来的清晰。
源码: v8/array-sort.tq at master · v8/v8 (github.com)
但是我是前端切图仔,所以我来用
js
实现一个简单版本的。
不过在这之前,我们准备一下。
提前需要了解的

2. 插入排序算法: Insertion sort - Wikipedia

3. 归并排序算法: Merge sort - Wikipedia

执行流程
-
首先自然是判断数组的长度,当小于2的时候完全没必要排序,直接
return; - 循环这个数组;
-
找到这个数组中的一个有序子序列,它将作为我们的
run; -
根据数组的长度计算
minrun,在[32 - 64]之间,如果长度小于64,则将minrun设置array.length; -
对比当前
run的长度和minrun,如果currentRunLength小于minRunLength,那么这个时候使用插入排序把这个run补充到长度为minRunLength; -
将
run压入栈中; -
保证栈内的任意从下到上的三个
run满足规则:
-
|C| > |B| + |A| -
|B| > |A|
如果不满足,合并其中两个较小的,如果还不满足,继续合并直到满足规则;
8. 如果此时没有剩余子数组了,说明可以结束循环了;
9. 合并栈里面所有的
run
,排序结束。
环境准备
由于涉及到的东西较多,所以准备分几个文件,这样比较清晰。
mkdir timsort
cd timesort
mkdir src
tsc --init
npm init --yes
然后还需要搞一下测试环境,需要引入
jest
[10]
和
ts-jest
[11]
npm install jest ts-jest typescript @types/node @types/jest -D
npx ts-jest config:init
然后配置下
jest
的语法提示,在
ts.config.json
中将
lib
改为
"types": ["jest"],
那么就可以了。
如果对这块感兴趣可以去看我之前的文章: 如何单元测试typescript - 知乎 (zhihu.com)
二分查询
就不解释了,直接上代码
先创建一个
binary_search.ts
文件和
util.ts
文件
我们把一些公共的方法放到这个
util.ts
文件中
export function lessThan (target: number, value: number): boolean {
  return target < value
export function equalTo (target: number, value: number): boolean {
  return target === value
然后我们来实现这个
binarySearch
import { equalTo, lessThan } from "./util";
// 二分搜索
export function binarySearch(
  array: number[],
  first: number,
  last: number,
  value: number
): number {
  while (first < last) {
    var mid = last + ((first - last) >> 1);
    if (lessThan(value, array[mid])) {
      last = mid;
    } else if (equalTo(value, array[mid])) {
      return mid;
    } else {
      first = mid + 1;
  return first;
写完之后需要测试下,我们还需要引入测试代码。
我们在根目录下创建
__tests__
文件夹
然后在里面创建
binary_search.spec.ts
文件
import { binarySearch } from "../src/binary_search";
test('test binary search', () => {
  const arr = [1, 2, 3, 4, 6, 20, 30];
  const res = binarySearch(arr, 0, arr.length - 1, 6);
  expect(res).toBe(4);
然后终端
jest -t test binary search

测试正常
二分排序
这个方法需要用到我们上面实现的
binary_search
。
同样的,我们创建
binary_sort.ts
文件
 import { binarySearch } from "./binary_search";
export function binarySort(
  array: number[],
  first: number,
  last: number,
  sortStart: number
): number[] {
  sortStart = sortStart || first;
  for (let i = sortStart; i <= last; i++) {
    cyclicRShift(array, binarySearch(array, first, i, array[i]), i);
  return array;
function cyclicRShift(array: number[], first: number, last: number) {
  if (last - first <= 0) return array;
  const mostRight = array[last];
  for (let cur = last; cur > first; cur--) {
    array[cur] = array[cur - 1];
  array[first] = mostRight;
  return array;
然后编写测试文件
binary_sort.spec.ts
 import { binarySort } from "../src/binary_sort";
test('test_binary_sort', () => {
  const arr = [2, 5, 30, 6,12, 1, 3, 6, 4, 20];
  const res = binarySort(arr, 0, arr.length - 1, 2);
  expect(res.toString()).toBe('1,2,3,4,5,6,6,12,20,30');

测试正常。
这里简单的解释下这个算法, 这个算法是二分查询 + 插入排序,下一个元素通过二分查询来找到,然后用插入排序给排序。
归并排序
同样,我们创建一个
merge_sort.ts
文件
import { lessThan } from "./util";
export function mergeSort(array: number[], first: number, last: number) {
if (last - first <= 1) return array;
const mid = last + ((first - last) >> 1);
mergeSort(array, first, mid);
mergeSort(array, mid, last);
mergeNeighbor(array, first, mid, last);
return array;
function mergeNeighbor(
array: number[],
first
: number,
connect: number,
last: number
const left = array.slice(first, connect);
let lcur = 0,
llast = connect - first;
const right = array.slice(connect, last);
let rcur = 0,
rlast = last - connect;
let cur = first;
while (lcur < llast && rcur < rlast) {
const lval = left[lcur];
const rval = right[rcur];
if (!lessThan(rval, lval)) {
array[cur++] = lval;
lcur++;
} else {
array[cur++] = rval;
rcur++;
while (lcur < llast) array[cur++] = left[lcur++];
while (rcur < rlast) array[cur++] = right[rcur++];
return array;
同上创建一个测试用例
merge_sort.spec.ts
import { mergeSort } from "../src/merge_sort";
test('test_merge_sort', () => {
  const arr = [2, 5, 30, 6,12, 1, 3, 6, 4, 20];
  const res = mergeSort(arr, 0, arr.length);
  expect(res.toString()).toBe('1,2,3,4,5,6,6,12,20,30');
接着
jest test_merge_sort

测试正常。
这个归并排序是我们的入口。
打通流程
前面准备工作已经完毕,这里开始实现主要逻辑
我们不准备按上面说的执行流程顺序写,因为按顺序不太好一步一步的实现。
我们先来创建一个
timsort.ts
文件作为入口,然后调用
mergeSort
方法
import { mergeSort } from "./merge_sort";
export function timsort (array: number[]): number[] {
  if (array.length < 2) return array;
  return mergeSort(array, 0, array.length);
然后来实现循环 + 入栈 + 保持两个规则(变体),否则就合并,最终返回。
我们来修改下我们的
mergeSort
方法
import { lessThan } from "./util";
export function mergeSort(array: number[], first: number, last: number) {
  if (last - first <= 1) return array;
  const stack = [];
  let remain = first;
  while (remain < last) {
    stack.push({
      first: remain,
      last: remain + 1,
      length: 1,
    remain++;
    while (
      stack.length > 1 &&
      (remain >= last ||
        stack[stack.length - 2].length < stack[stack.length - 1].length * 2)
      const pre = stack[stack.length - 2];
      const cur = stack.pop();
      mergeNeighbor(array, pre.first, pre.last, cur!.last);
      pre.last = cur!.last;
      pre.length += cur!.length;
  return array;
function mergeNeighbor(
  array: number[],
  first: number,
  connect: number,
  last: number
  const left = array.slice(first, connect);
  let lcur = 0,
    llast = connect - first;
  const right = array.slice(connect, last);
  let rcur = 0,
    rlast = last - connect;
  let cur = first;
  while (lcur < llast && rcur < rlast) {
    const lval = left[lcur];
    const rval = right[rcur];
    if (!lessThan(rval, lval)) {
      array[cur++] = lval;
      lcur++;
    } else {
      array[cur++] = rval;
      rcur++;
  while (lcur < llast) array[cur++] = left[lcur++];
  while (rcur < rlast) array[cur++] = right[rcur++];
  return array;
我们把之前数组左右两部分的递归代码移除了,取而代之的是我们的循环。
这里有两层循环,逻辑比较简单。
第一层循环的条件是对
run
的切割,当切割完毕之后就结束了。每一次循环都会切割出来一个
run
,然后将它压入栈。
这里暂时限定死
minrun
为
1
,所以切割的时候都是一个个的元素。
第二层则是我们合并
run
的基础逻辑,我们这里暂时没有按照两个变体来合并,只是简单的判断下栈顶的第二个
run
的长度小于第一个的长度的两倍,那么就合并他俩。
然后我们重新跑下测试用例
jest -t test_merge_sort

正常,那么我们接下来实现
run
这块的逻辑。
实现截取和合并runs逻辑
merge_sort.ts
import { MergeState, Run } from "./../types/timsort.d";
import { lessThan, lessThanEqual, reverse } from "./util";
* @description timsort核心代码
export function mergeSort(
array: number[],
first: number,
last: number
): number[] {
const state: MergeState = {
array,
runStack: [],
remain: first,
last,
while (nextRun(state)) {
while (whenMerge(state)) {
mergeTwoRuns(state);
return array;
* @description 用于判断是否还需要截取以及截取run
function nextRun(state: MergeState): boolean {
const { remain, last: _state_last, array } = state;
if (remain >= _state_last) return false;
// 兼容最后一个元素没得比较的场景
if (_state_last - remain <= 1) {
cutRun(state, _state_last);
return true;
let last = remain; // run最终长度的索引值,从remain开始
// 获取此次比对的两个元素,比对仅是为了确认接下来是递增还是递减
let prev = array[last++];
const lastVal = array[last++];
// 判断是递增还是递减
const isAscendant = lessThanEqual(prev, lastVal);
prev = lastVal;
// 找到排序好了的子序列
while (last < _state_last) {
const nextItem = array[last];
// 如果当前元素小于等于下一个元素
const isLessThanEqual = lessThanEqual(prev, nextItem);
// 递增过程如果遇到下一个元素小于等于当前元素的时候直接截断
// 递减过程如果遇到下一个元素大于当前元素的时候直接截断,注意,递减过程不支持等于
if ((!isLessThanEqual && isAscendant) || (isLessThanEqual && !isAscendant))
break;
prev = nextItem;
last++;
// 如果是递减,那么需要转一下方向
if (!isAscendant) {
reverse(array, remain, last);
// 截取这个天然排序好了的子序列
cutRun(state, last);
return true;
* @description 截取run并存入栈中
* first表示这个run的起始位置索引
* last自然就是run的结束位置索引
* 注意这个run的范围是[first, last)
* 而下一次截取到的范围则是从这个last的索引作为first/remain开始的范围
function cutRun(state: MergeState, last: number) {
const { remain, runStack } = state;
const run: Run = {
first: remain,
last,
length: last - remain,
runStack.push(run);
state.remain = last;
* @description 对于任意栈顶的三个run之间保持以下规则
* 1. |C| > |B| + |A|
* 2. |B| > |A|
* 如果不满足,合并较小的两个run
* 比如:[1] => [1,1] => [2] => [2,1] => [2,1,1] => [2,2] => [4]
function whenMerge(state: MergeState): boolean {
const { remain, last, runStack } = state;
// remain === last表示当前已经全部截取完毕,此时如果栈里存在两个及以上的run,返回true表示需要将它们合并
if (remain === last) return runStack.length > 1;
if (runStack.length <= 1) return false;
const length = runStack.length;
// 栈顶第一个run
const curRun: Run = runStack[length - 1];
// 栈顶第二个run
const preRun: Run = runStack[length - 2];
// 如果此时栈顶第二个run短于栈顶第一个run,合并处理
if (length === 2) return preRun.length <= curRun.length;
// 栈顶第三个run
const ppreRun: Run = runStack[length - 3];
return ppreRun.length <= preRun.length + curRun.length;
* @description 根据不同场景合并两个run
function mergeTwoRuns(state: MergeState) {
const { runStack } = state;
const length = runStack.length;
// 当栈顶run比栈顶第三个都要长,这个时候合并栈顶第二和第三个run
// 直到保持|C| > |B| + |A|为止
if (length > 2 && runStack[length - 3].length < runStack[length - 1].length) {
const curRun = runStack.pop();
mergeHeadRuns(state);
// 第二个第二个合并完之后当前的run需要再push回去
runStack.push(curRun as Run);
} else {
mergeHeadRuns(state);
* @description 合并run
function mergeHeadRuns(state: MergeState) {
const { runStack, array } = state;
const firRun: Run = runStack.pop() as Run;
const secRun: Run = runStack[runStack.length - 1];
// 把栈顶前一个的run合并到第二个run里面
mergeNeighbor(array, secRun.first, firRun.first, firRun.last, state);
// 数据需要同步调整
secRun.last = firRun.last;
secRun.length += firRun.length;
* @description 归并排序核心,合并两个数组
function mergeNeighbor(
array: number[],
first: number,
connect: number,
last: number,
state: MergeState
const left = array.slice(first, connect);
let lcur = 0,
llast = connect - first;
const right = array.slice(connect, last);
let rcur = 0,
rlast = last - connect;
let cur = first;
while (lcur < llast && rcur < rlast) {
const lval = left[lcur];
const rval = right[rcur];
if (!lessThan(rval, lval)) {
array[cur++] = lval;
lcur++;
} else {
array[cur++] = rval;
rcur++;
while (lcur < llast) array[cur++] = left[lcur++];
while (rcur < rlast) array[cur++] = right[rcur++];
return array;
util.ts
 export function lessThan(a: number, b: number): boolean {
  return a < b;
export function equalTo(a: number, b: number): boolean {
  return a === b;
export function lessThanEqual(a: number, b: number): boolean {
  return a <= b;
export function reverse(array: number[], first: number, last: number) {
  last--;
  while (first < last) {
    const tmp = array[first];
    array[first] = array[last];
    array[last] = tmp;
    first++;
    last--;
另外这里还搞了一个
src/types/timsort.d.ts
的类型定义文件
 export interface MergeState {
    array: number[];
    remain: number;
    last: number;
    runStack: Run[];
export interface Run {
    first: number;
    last: number;
    length: number;
稍微说下,我们这一步主要是在实现
run
从数组中的截取和栈中
run
的合并逻辑。
具体分析都写在注释里了。
我们再来运行下
jest -t test_merge_sort

测试正常。
emmm,实际上这里应该多搞几个测试用例才对。
补充测试用例
多搞几个测试用例,避免存在边界问题
import { timsort } from "../src/timsort";
describe("test_tim_sort", () => {
test('test_only_one_element', () => {
const arr = [1];
const res = timsort(arr);
expect(res.toString()).toBe("1");
test('test_reverse', () => {
const arr = [5, 3, 2, 1];
const res = timsort(arr);
expect(res.toString()).toBe("1,2,3,5");
test('test_descendant', () => {
const arr = [5, 7, 4, 3, 2, 1];
const res = timsort(arr);
expect(res.toString()).toBe("1,2,3,4,5,7");
test("test_random", () => {
const arr = [];
for (let i = 0; i < 257; i++) {
arr.push(Math.random() * 100);
const copyArrStr = [...arr].sort((a, b) => a - b).join(",");
const res = timsort(arr);
expect(res.toString()).toBe(copyArrStr);
test("test_merge_sort", () => {
const arr = [2, 5, 30, 6, 12, 1, 3, 6, 4, 20];
const res = timsort(
arr);
expect(res.toString()).toBe("1,2,3,4,5,6,6,12,20,30");
暂时就搞这几个
然后我们终端输入指令
jest -t test_tim_sort

也是正常的。
minrun
那么接下来我们来实现
minrun
这块的逻辑
现在我们的代码中暂时还是以
1
为
minrun
,我们来修改下,修改成根据数组长度来设置
minrun
。
// ...
 * @description timsort核心代码
export function mergeSort(
  array: number[],
  first: number,
  last: number
): number[] {
  const state: MergeState = {
    array,
    runStack: [],
    remain: first,
    last,
+   minrun: getMinrun(last - first),
  while (nextRun(state)) {
    while (whenMerge(state)) {
      mergeTwoRuns(state);
  return array;
 * @description 获取minrun
 * 范围在[32, 64]当array的长度大于等于64的时候,否则按数组自身大小计算
function getMinrun (n: number): number {
    // 当大于等于64的时候进行右移一位降低到[32, 64]之间。
    // 比如: 1=>1, ..., 63=>63, 64=>32, 65=>33, ..., 127=>64, 128=>32, ...
    let r = 0;
    while (n >= 64) {
        r = r | n & 1;
        n = n >> 1;
    return n + r;
 * @description 用于判断是否还需要截取以及截取run
function nextRun(state: MergeState): boolean {
  const { remain, last: _state_last, array, minrun } = state;
  // ...
  // 如果是递减,那么需要转一下方向
  if (!isAscendant) {
    reverse(array, remain, last);
  // 如果截取的子序列小于minrun,那么这个时候进行补足
  // 补足方式是通过二分排序
+ if (last - remain < minrun) {
+     const minrunLength = remain + minrun;
+     // 排序的起始位置,[remain, last]之间没必要再跟着排序,前面已经排好了
+     const sortStart = last;
+     // 如果此时剩余不足minrun,那么截取最后一段即可。
+     last = minrunLength > _state_last ? _state_last : minrunLength;
+     binarySort(array, remain, last - 1, sortStart);
 // ...
// ...
这块实现的点主要是截取
run
的时候如果长度小于
minrun
,那么使用我们之前写好的
binarySort
来二分补足
run
直到长度到
minrun
为止。
然后再跑一下测试用例
jest -t test_tim_sort

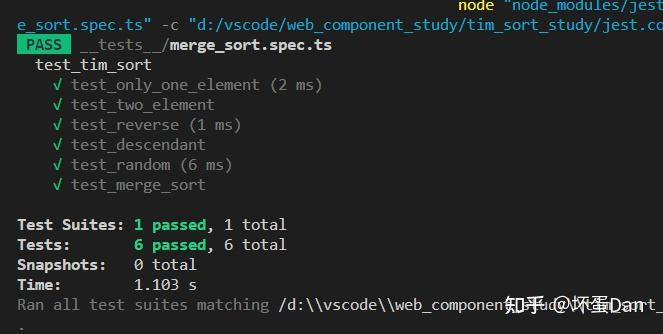
测试正常
优化合并逻辑
我们前面的合并逻辑实际上还没完成,我们并没有实现穿插合并以及快速增加模式(
galloping mode
)。
现在我们先来优化合并这块逻辑,减少一些没必要的合并。
// ...
* @description 归并排序核心,合并两个数组
function mergeNeighbor(
array: number[],
first: number, // 按栈顶往下的规则,比如[B, A], A更靠近栈顶。这个first是B的first,因为切割顺序是从左到右,B的切割早于A。
connect: number, // 按栈顶往下的规则,比如[B, A],这个是A的first,因为切割`run`的过程是从左到右的,所以A实际上是在B之后截取的。
last: number, // 同上描述,这个是A的last
state: MergeState
const l_length = connect - first;
const r_length = last - connect;
// 从左合并还是从又合并取决于两个run的长度,哪边短则合并到那边。
const func = l_length < r_length ? mergeIntoLeft : mergeIntoRight;
// 由于两段代码有些比较类似,但是为了方便理解,拆开来较好。
return func(array, first, connect, last, state);
* @description 左边比较短,这个时候右边合并到左边,这个过程中存在一些不需要参与的元素
* 找到左边小于等于右边第一个元素的元素的位置
* 比如:[1, 5]和[2, 3, 6]
* 此时左边小于等于右边第一个元素的位置是`0`,那么元素`1`可以不参与排序
* 那么需要排序的元素变成[5]和[2, 3, 6]
function mergeIntoLeft(
array: number[],
first: number,
connect: number,
last: number,
state: MergeState
const m: MergeItem = {
right: array,
r_cur: connect,
r_last: last,
cur: -1,
l_cur: 0,
l_last: -1,
left: [],
// 二分查询找到左边第一个小于等于右边第一个元素的元素的位置
m.cur = binarySearch(array, first, connect, m.right[m.r_cur]);
// 截取左边需要排序的个数
m.l_last = connect - m.cur;
// 截取左边需要排序的元素
m.left = array.slice(m.cur, connect);
// 遍历排序两个数组
// 左边的从截取位置开始匹配
// 右边全匹配
while (m.l_cur < m.l_last && m.r_cur < (m.r_last as number)) {
const l_val = m.left[m.l_cur];
const r_val = m.right[m.r_cur];
// 如果左边当前匹配的元素小于等于右边的,那么就找到位置了,将该值插入到里面
// 否则插入右边当前匹配的元素
if (lessThanEqual(l_val, r_val)) {
array[m.cur++] = l_val;
m.l_cur++;
} else {
array[m.
cur++] = r_val;
m.r_cur++;
// 如果这个时候左边还有剩下的元素,那么就说明右边被匹配完了。
// 剩下的左边元素必定大于任何右边元素,可以直接放到合并的数组后面
while (m.l_cur < m.l_last) {
array[m.cur++] = m.left[m.l_cur++];
return array;
* @description 右边比较短,左边合并到右边,这个过程存在一些不需要参与的元素。
* 找到右边大于左边最后一个元素的元素的位置
* 比如:[1, 3, 4]和[2, 5]
* 此时找到右边的位置是`1`,那么元素`5`不需要参与排序
* 那么就变成[1, 3, 4]和[2]的排序
function mergeIntoRight(
array: number[],
first: number,
connect: number,
last: number,
state: MergeState
const m: MergeItem = {
left: array,
l_cur: connect,
l_first: first,
cur: -1,
r_cur: 0,
r_first: 0,
right: [],
// 找到右边第一个大于左边最后一个元素的元素的位置
m.cur = binarySearch(array, connect, last, m.left[m.l_cur - 1]);
// 截取需要排序的部分
m.right = array.slice(connect, m.cur);
// 截取需要排序的个数
m.r_cur = m.cur - connect;
// 遍历两个数组,左边的全参与,右边仅截取的部分参与
while ((m.l_first as number) < m.l_cur && (m.r_first as number) < m.r_cur) {
const l_val = m.left[m.l_cur - 1];
const r_val = m.right[m.r_cur - 1];
// 如果右边当前匹配的元素的小于左边当前匹配的位置,那么就找到位置了,插入左边的值
// 否则插入右边元素
if (lessThan(r_val, l_val)) {
array[--m.cur] = l_val;
--m.l_cur;
} else {
array[--m.cur] = r_val;
--m.r_cur;
// 最后如果右边还有剩余的元素,那么就说明右边的元素一定都小于左边的元素,可以直接放到数组的最前面。
while ((m.r_first as number) < m.r_cur) {
array[--m.cur] = m.right[--m.r_cur];
return array;
这里主要是在优化合并的逻辑,因为合并的过程中其实有些元素没必要参与合并排序逻辑,把这块忽略掉可以省下一些时间。
具体的描述我都写到注释里了。
然后再跑下
jest -t test_tim_sort

测试正常
不过这块逻辑的优化效果实际上并不是很好,我们可以看到这里只能是过滤掉其中一个数组的其中一边,有没有办法可以过滤两个数组的两边呢?
当然可以,就是前面说的左边部分插右边,右边部分也插左边的逻辑
实现galloping mode
那么差不多了,我们来接入最后的一部分:
galloping mode
// ...
+ const MIN_GALLOP = 7; // 初始阈值
export function mergeSort(
array: number[],
first: number,
last: number
): number[] {
const state: MergeState = {
array,
runStack: [],
remain: first,
last,
minrun: getMinrun(last - first),
+ minGallop: MIN_GALLOP,
while (nextRun(state)) {
while (whenMerge(state)) {
mergeTwoRuns(state);
return array;
// ...
// ---------------------------------------merge into left start-------------------------------------
* @description 左边比较短,这个时候右边合并到左边,这个过程中存在一些不需要参与的元素
* 找到左边小于等于右边第一个元素的元素的位置
* 比如:[1, 5]和[2, 3, 6]
* 此时左边小于等于右边第一个元素的位置是`0`,那么元素`1`可以不参与排序
* 那么需要排序的元素变成[5]和[2, 3, 6]
function mergeIntoLeft(
array: number[],
first: number,
connect: number,
last: number,
state: MergeState
const m: MergeItem = {
right: array,
r_cur: connect,
r_last: last,
cur: -1,
l_cur: 0,
l_last: -1,
left: [],
galloping: false,
gallopingOut: false,
selectLeft: true,
selectCount: 0,
// 二分查询找到左边第一个小于等于右边第一个元素的元素的位置
m.cur = binarySearch(array, first, connect, m.right[m.r_cur]);
// 截取左边需要排序的个数
m.l_last = connect - m.cur;
// 截取左边需要排序的元素
m.left = array.slice(m.cur, connect);
// 遍历排序两个数组
// 左边的从截取位置开始匹配
// 右边全匹配
while (m.l_cur < m.l_last && m.r_cur < (m.r_last as number)) {
if (!m.galloping) {
mergeLeftOnePairMode(array, state, m);
} else {
mergeLeftGallopingMode(array, state, m);
// 如果这个时候左边还有剩下的元素,那么就说明右边被匹配完了。
// 剩下的左边元素必定大于任何右边元素,可以直接放到合并的数组后面
while (m.l_cur < m.l_last) {
array[m.cur++] = m.left[
m.l_cur++];
return array;
* @description 常规合并到左边,因为存在不需要galloping的场景
function mergeLeftOnePairMode(
array: number[],
state: MergeState,
m: MergeItem
// 如果左边当前匹配的元素小于等于右边的,那么就找到位置了,将该值插入到里面
// 否则插入右边当前匹配的元素
const l_val = m.left[m.l_cur];
const r_val = m.right[m.r_cur];
if (lessThanEqual(l_val, r_val)) {
array[m.cur++] = l_val;
m.l_cur++;
// 如果发现是左边的小,这个时候连续被打破,需要切换状态
modeControlInOnePairMode(state, m, !m.selectLeft);
} else {
array[m.cur++] = r_val;
m.r_cur++;
modeControlInOnePairMode(state, m, m.selectLeft as boolean);
* @description 使用快速增加模式合并
* 找到左右两边的连续元素组,然后一次性插入,准确的来说应该是移动到对应的位置,因为都是在同一个数组里操作的
function mergeLeftGallopingMode(
array: number[],
state: MergeState,
m: MergeItem
if (state.minGallop > 0) state.minGallop--;
const l_val = m.left[m.l_cur];
const r_val = m.right[m.r_cur];
if (lessThanEqual(l_val, r_val)) {
// 找到左边连续小于等于右边的部分
const end = gallopFirstSearch(
m.left,
m.l_cur + 1,
m.l_last as number,
r_val
modeControlInGallopingMode(state, m, end - m.l_cur);
// 将这部分连续的元素都插入到对应的位置
while (m.l_cur < end) array[m.cur++] = m.left[m.l_cur++];
} else {
// 找到右边连续小于左边的部分
const end = gallopFirstSearch(
m.right,
m.r_cur + 1,
m.r_last as number,
l_val
modeControlInGallopingMode(state, m, end - m.r_cur);
// 将这部分连续的元素都插入到对应的位置
while (m.r_cur < end) array[m.cur++] = m.right[m.r_cur++];
// ---------------------------------------merge into left end-------------------------------------
// ---------------------------------------merge into right start-------------------------------------
* @description 右边比较短,左边合并到右边,这个过程存在一些不需要参与的元素。
* 找到右边大于左边最后一个元素的元素的位置
* 比如:[1, 3, 4]和[2, 5]
* 此时找到右边的位置是`1`,那么元素`5`不需要参与排序
* 那么就变成[1, 3, 4]和[2]的排序
function mergeIntoRight(
array: number[],
first: number,
connect: number,
last: number,
state: MergeState
const m: MergeItem = {
left: array,
l_cur: connect,
l_first: first,
cur: -1,
r_cur: 0,
r_first: 0,
right: [],
galloping: false,
gallopingOut: false,
selectLeft: true,
selectCount: 0,
// 找到右边第一个大于左边最后一个元素的元素的位置
m.cur = binarySearch(array, connect, last, m.left[m.l_cur - 1]);
// 截取需要排序的部分
m.right = array.slice(connect, m.cur);
// 截取需要排序的个数
m.r_cur = m.cur - connect;
// 遍历两个数组,左边的全参与,右边仅截取的部分参与
while ((m.l_first as number) < m.l_cur && (m.r_first as number) < m.r_cur) {
if (!m.galloping) {
mergeRightOnePairMode(array, state, m);
} else {
mergeRightGallopingMode(array, state, m);
// 最后如果右边还有剩余的元素,那么就说明右边的元素一定都小于左边的元素,可以直接放到数组的最前面。
while ((m.r_first as number) < m.r_cur) {
array[--m.cur] = m.right[--m.r_cur];
return array;
* @description 常规合并到右边
function mergeRightOnePairMode(
array: number[],
state: MergeState,
m: MergeItem
// 如果右边当前匹配的元素的小于左边当前匹配的位置,那么就找到位置了,插入左边的值
// 否则插入右边元素
const l_val = m.left[m.l_cur - 1];
const r_val = m.right[m.r_cur - 1];
if (lessThan(r_val, l_val)) {
array[--m.cur] = l_val;
--m.l_cur;
modeControlInOnePairMode(state, m, !m.selectLeft);
} else {
array[--m.cur] = r_val;
--m.r_cur;
modeControlInOnePairMode(state, m, m.selectLeft as boolean);
* @description 快速增长模式下合并
* 获取两边连续的部分,然后批量将它们合并
function mergeRightGallopingMode(
array: number[],
state: MergeState,
m: MergeItem
if (state.minGallop > 0) state
.minGallop--;
const l_val = m.left[m.l_cur - 1];
const r_val = m.right[m.r_cur - 1];
if (lessThan(r_val, l_val)) {
// 获取右边连续小于左边的元素,也就是左边连续大于等于右边的部分
const begin = gallopLastSearch(
m.left,
m.l_first as number,
m.l_cur - 1,
r_val
modeControlInGallopingMode(state, m, m.l_cur - begin);
// 批量移动
while (begin < m.l_cur) array[--m.cur] = m.left[--m.l_cur];
} else {
// 获取右边连续大于等于左边的元素
const begin = gallopLastSearch(
m.right,
m.r_first as number,
m.r_cur - 1,
l_val
modeControlInGallopingMode(state, m, m.r_cur - begin);
// 批量移动
while (begin < m.r_cur) array[--m.cur] = m.right[--m.r_cur];
// ---------------------------------------merge into right end-------------------------------------
* @description 切换收集的状态,如果连续达到galloping个,那么就切换`galloping`状态。
function modeControlInOnePairMode(
state: MergeState,
m: MergeItem,
selectSwitched: boolean
if (selectSwitched) {
m.selectLeft = !m.selectLeft;
m.selectCount = 0;
m.selectCount++;
if (m.selectCount >= state.minGallop) {
m.galloping = true;
m.selectCount = 0;
* @description 当galloping可操作数量小于最小阈值,此时停止galloping,回归常规合并
function modeControlInGallopingMode(
state: MergeState,
m: MergeItem,
gallopSize: number
if (gallopSize < MIN_GALLOP) {
if (m.gallopingOut) {
m.galloping = false;
m.gallopingOut = false;
state.minGallop++;
} else {
m.gallopingOut = true;
} else {
m.gallopingOut = false;
* @description 找到一组连续小于/大于(等于)的元素,方向是正常的左到右
function gallopFirstSearch(
array: number[],
first: number,
last: number,
value: number
): number {
let pre = 0;
let offset = 1;
while (first + offset < last) {
if (lessThan(value, array[first + offset])) break;
pre = offset;
offset = (offset << 1) + 1;
const searchFirst = first + pre;
const searchLast = first + offset < last ? first + offset : last;
// 找到第一个元素在整个数组中的位置
return binarySearch(array, searchFirst, searchLast, value);
* @description 也是找到一组连续的元素,但是方向是从右到左,也就是从后往前
function gallopLastSearch(
array: number[],
first: number,
last: number,
value: number
let pre = 0;
let offset = 1;
while (first < last - offset) {
if (!lessThan(value, array[last - offset])) break;
pre = offset;
offset = (offset << 1) + 1;
const searchFirst = (first < last - offset) ? last - offset : first;
const searchLast = last - pre;
return binarySearch(array, searchFirst, searchLast, value);
最小的阈值是
7
,所以小于这个阈值的时候就只是常规的合并处理(也就是之前写的合并方式)
如果是
galloping mode
,那么会批量收集小于/大于(等于)另一边元素的元素组,然后批量移动,这样就优化了我们上面说的只能过滤其中一个数组的一边的情况。
现在我们可以只会截取两个数组里面的需要排序的部分,其它都不再参与排序。
具体的看注释。
然后还是老规矩
jest -t test_tim_sort

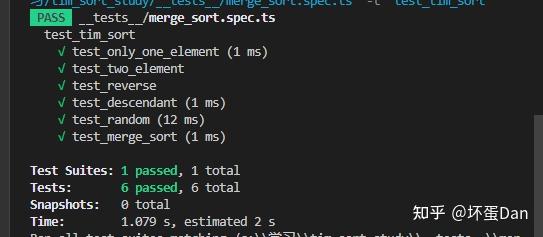
测试正常
对比快速排序
前面说了这个是用来替换原来的快速排序的,所以我们来比对下,看下是否真的比快排快。
v8
引擎之前是少于某个数字时直接用插入排序,否则采用快速排序,这里就不考虑了。
直接用快排来比较。
实现快速排序
export function quickSort(arr: number[]) {
function _quickSort(arr: number[], start: number, end: number) {
if (start >= end) return;
let key = arr[end];
let left = start,
right = end - 1;
while (left < right) {
while (arr[left] < key &&
left < right) left++;
while (arr[right] >= key && left < right) right--;
[arr[left], arr[right]] = [arr[right], arr[left]];
if (arr[left] >= arr[end]) {
[arr[left], arr[end]] = [arr[end], arr[left]];
} else {
left++;
_quickSort(arr, start, left - 1);
_quickSort(arr, left + 1, end);
_quickSort(arr, 0, arr.length - 1);
return arr;
然后写个测试文件
quick_sort.spec.ts
测试下代码是否正常
import { quickSort } from "../src/quick_sort";
test('test_quick_sort', () => {
  const arr = [];
  for (let i = 0; i < 1257; i++) {
    arr.push(Math.floor(Math.random() * 100));
  const copyArr = [...arr].sort((a, b) => (a - b));
  const copyStr = copyArr.join(',');
  const res = quickSort(arr);
  expect(res.toString()).toBe(copyStr);
然后
jest -t test_quick_sort

测试正常
速度对比1:全随机
那么可以开始对比了。
我们先来设计下测试用例
循环个
500
遍,每一次都创建随机数组,长度固定为
20000
个,然后收集两者时间差总数。
我们创建一个
compare.spec.ts
第一组来个全随机的,按理说应该是快排快。
  test("test_compare_with_all_random", () => {
    let num1 = 0;
    let num2 = 0;
    let num3 = 0;
    for (let i = 0; i < 500; i++) {
      const arr = [];
      const arr2 = [];
      const arr3 = [];
      for (let j = 0; j < 20000; j++) {
        const ran_num = Math.random() * 200;
        arr.push(ran_num);
        arr2.push(ran_num);
        arr3.push(ran_num);
      const q_date_begin = new Date().getTime();
      quickSort(arr);
      const q_date_end = new Date().getTime();
      const final_q_time = q_date_end - q_date_begin;
      num1 += final_q_time;
      const t_date_begin = new Date().getTime();
      timsort(arr2);
      const t_date_end = new Date().getTime();
      const final_t_time = t_date_end - t_date_begin;
      num2 += final_t_time;
      // 原生sort
      const ot_date_begin = new Date().getTime();
      arr3.sort((a, b) => a - b)
      const ot_date_end = new Date().getTime();
      const final_ot_time = ot_date_end - ot_date_begin;
      num3 += final_ot_time;
    // 从左到右依次是快排,我们实现的timsort, sort方法
    console.log(num1, num2, num3);
    expect(num1 < num2).toBe(true);
然后执行
jest -t test_compare_with_all_random

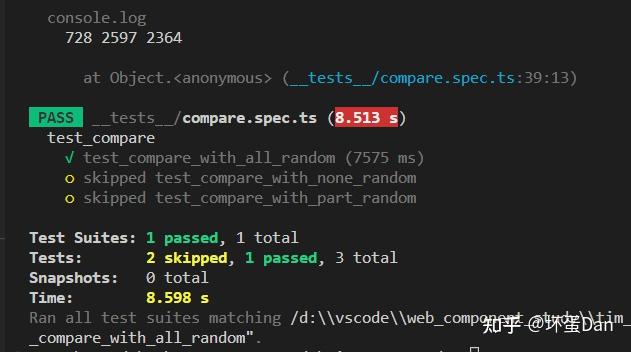
可以看到快排明显快很多。这个表现是正常的,前面也有说过,这里就不多说了
为了确保效果和原版的差不多,我们也和原生的
sort
方法来对比
可以看到原生的
sort
也差不多3倍多左右
速度对比2:部分随机
然后我们来试下部分内容是连续的递增/递减的。
我们给随机的数组随机截取一部分内容给它们排序。
  test("test_compare_with_part_random", () => {
    let num1 = 0;
    let num2 = 0;
    let num3 = 0;
    const { floor, random } = Math;
    for (let i = 0; i < 50; i++) {
      let arr = [];
      let arr2 = [];
      let arr3 = [];
      for (let j = 0; j < 20000; j++) {
        const ran_num = floor(random() * 20000);
        arr.push(ran_num);
        arr2.push(ran_num);
        arr3.push(ran_num);
      const sortBeginIndex = getRandomIndexArr();
      for (let i = 0; i < sortBeginIndex.length; i++) {
        const begin = sortBeginIndex[i];
        const randomSortNum = floor(random() * 200);
        arr = sortAndConcatArr(arr, begin, randomSortNum);
        arr2 = sortAndConcatArr(arr2, begin, randomSortNum);
        arr3 = sortAndConcatArr(arr3, begin, randomSortNum);
      const q_date_begin = new Date().getTime();
      quickSort(arr);
      const q_date_end = new Date().getTime();
      const final_q_time = q_date_end - q_date_begin;
      num1 += final_q_time;
      const t_date_begin = new Date().getTime();
      timsort(arr2);
      const t_date_end = new Date().getTime();
      const final_t_time = t_date_end - t_date_begin;
      num2 += final_t_time;
      // 原生sort
      const ot_date_begin = new Date().getTime();
      arr3.sort((a, b) => a - b)
      const ot_date_end = new Date().getTime();
      const final_ot_time = ot_date_end - ot_date_begin;
      num3 += final_ot_time;
    // 从左到右依次是快排,我们实现的timsort, sort方法
    console.log(num1, num2, num3);
    expect(num1 > num2).toBe(true);
    function sortAndConcatArr(arr: number[], index: number, randomSortNum: number) {
      const left = arr.slice(0, index);
      const middle = arr.slice(index, index + randomSortNum);
      const right = arr.slice(index + randomSortNum);
      middle.sort((a, b) => a - b);
      return [...left, ...middle, ...right];
    function getRandomIndexArr (): number[] {
      const arr = []
      const randomNum = 99;
      let lastRandomNum = 0;
      for (let i = 0; i < randomNum; i++) {
        const r = lastRandomNum + random() * 200;
        lastRandomNum = r;
        arr.push(r);
      return arr;
jest -t test_compare_with_part_random

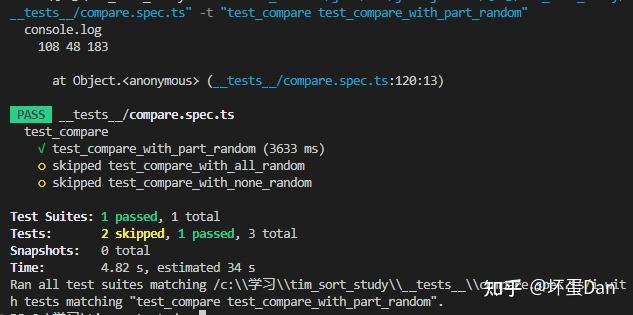
可以看到这次我们的
timsort
比
quicksort
耗时少了一半
速度对比3:没有随机
顾名思义,就是全部排序好了的,这个时候我们的
timsort
耗时应该是非常小的
这里将数组长度调整为2000,因为快排递归炸了
  test("test_compare_with_none_random", () => {
    let num1 = 0;
    let num2 = 0;
    for (let i = 0; i < 500; i++) {
      const arr = [];
      const arr2 = [];
      for (let j = 0; j < 2000; j++) {
        const ran_num = Math.random() * 200;
        arr.push(ran_num);
        arr2.push(ran_num);
      arr.sort((a, b) => a - b);
      arr2.sort((a, b) => a - b);
      const q_date_begin = new Date().getTime();
      quickSort(arr);
      const q_date_end = new Date().getTime();
      const final_q_time = q_date_end - q_date_begin;
      num1 += final_q_time;
      const t_date_begin = new Date().getTime();
      timsort(arr2);
      const t_date_end = new Date().getTime();
      const final_t_time = t_date_end - t_date_begin;
      // 相等也不行