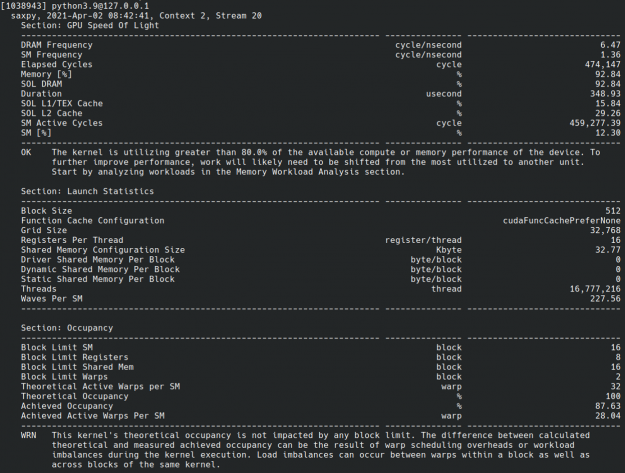
由於 Python 是一種解譯語言,必須先設法將裝置程式碼編譯成 PTX,然後擷取將要在應用程式中呼叫的函數。相比之下理解 CUDA Python 不是最重要的,但是需要瞭解 Parallel Thread Execution(
PTX
)是一種低階虛擬機器和指令集架構(instruction set architecture,ISA)。以字串形式建構裝置程式碼,並使用 CUDA C++ 執行階段編譯函式庫
NVRTC
進行編譯。使用 NVIDIA
驅動程式 API
,在 GPU 上手動建立 CUDA 脈絡及所有的必要資源,然後啟動已編譯 CUDA C++ 程式碼,並從 GPU 擷取結果。現在,您已經大致瞭解,接著將進入平行程式設計的常用範例:
SAXPY
。
def ASSERT_DRV(err):
    if isinstance(err, cuda.CUresult):
       if err != cuda.CUresult.CUDA_SUCCESS:
           raise RuntimeError("Cuda Error: {}".format(err))
   elif isinstance(err, nvrtc.nvrtcResult):
       if err != nvrtc.nvrtcResult.NVRTC_SUCCESS:
           raise RuntimeError("Nvrtc Error: {}".format(err))
   else:
       raise RuntimeError("Unknown error type: {}".format(err))
常見之做法是在轉譯單位的頂部附近編寫 CUDA 核心,所以接下來將編寫此部分。使用三引號包住整個核心,以形成字串。之後使用 NVRTC 編譯字串。這是 CUDA Python 中唯一需要理解 CUDA C++ 的部分。若需要更多資訊,請參閱
An Even Easier Introduction to CUDA
。
saxpy = """\
extern "C" __global__
void saxpy(float a, float *x, float *y, float *out, size_t n)
size_t tid = blockIdx.x * blockDim.x + threadIdx.x;
if (tid < n) {
out[tid] = a * x[tid] + y[tid];
# The following code example is not intuitive
# Subject to change in a future release
dX = np.array([int(dXclass)], dtype=np.uint64)
dY = np.array([int(dYclass)], dtype=np.uint64)
dOut = np.array([int(dOutclass)], dtype=np.uint64)
args = [a, dX, dY, dOut, n]
args = np.array([arg.ctypes.get_data() for arg in args], dtype=np.uint64)
現在可以啟動核心:
err, = cuda.cuLaunchKernel(
kernel,
NUM_BLOCKS, # grid x dim
1, # grid y dim
1, # grid z dim
NUM_THREADS, # block x dim
1, # block y dim
1, # block z dim
0, # dynamic shared memory
stream, # stream
args.ctypes.get_data(), # kernel arguments
0, # extra (ignore)
err, = cuda.cuMemcpyDtoHAsync(
hOut.ctypes.get_data(), dOutclass, bufferSize, stream
err, = cuda.cuStreamSynchronize(stream)
cuLaunchKernel 函式取得已編譯的模組核心和執行配置參數。在與資料傳輸相同的資料流中啟動裝置程式碼。可以確保僅會在完成資料傳輸後,執行核心運算,因為資料流中的所有 API 呼叫及核心啟動都已經序列化。在將資料傳回主機的呼叫之後,使用 cuStreamSynchronize 暫停 CPU 執行,直至完成指定資料流中的所有運算。
# Assert values are same after running kernel
hZ = a * hX + hY
if not np.allclose(hOut, hZ):
raise ValueError("Error outside tolerance for host-device vectors")