


最全最新分享:mysql索引的数据结构!含mysql面试专题及答案

索引
MySQL官方对索引的定义为:索引(Index)是帮助MySQL高效获取数据的数据结构。
我们知道,数据库查询是数据库的最主要功能之一。我们都希望查询数据的速度能尽可能的快,因此数据库系统的设计者会从查询算法的角度进行优化。
最基本的查询算法当然是顺序查找(linear search),这种复杂度为O(n)的算法在数据量很大时显然是糟糕的,好在计算机科学的发展提供了很多更优秀的查找算法,例如二分查找(binary search)、二叉树查找(binary tree search)等。
如果稍微分析一下会发现,每种查找算法都只能应用于特定的数据结构之上,例如二分查找要求被检索数据有序,而二叉树查找只能应用于二叉查找树上,但是数据本身的组织结构不可能完全满足各种数据结构(例如,理论上不可能同时将两列都按顺序进行组织),所以,在数据之外,数据库系统还维护着满足特定查找算法的数据结构,这些数据结构以某种方式引用(指向)数据,这样就可以在这些数据结构上实现高级查找算法。这种数据结构,就是索引。
看一个例子:

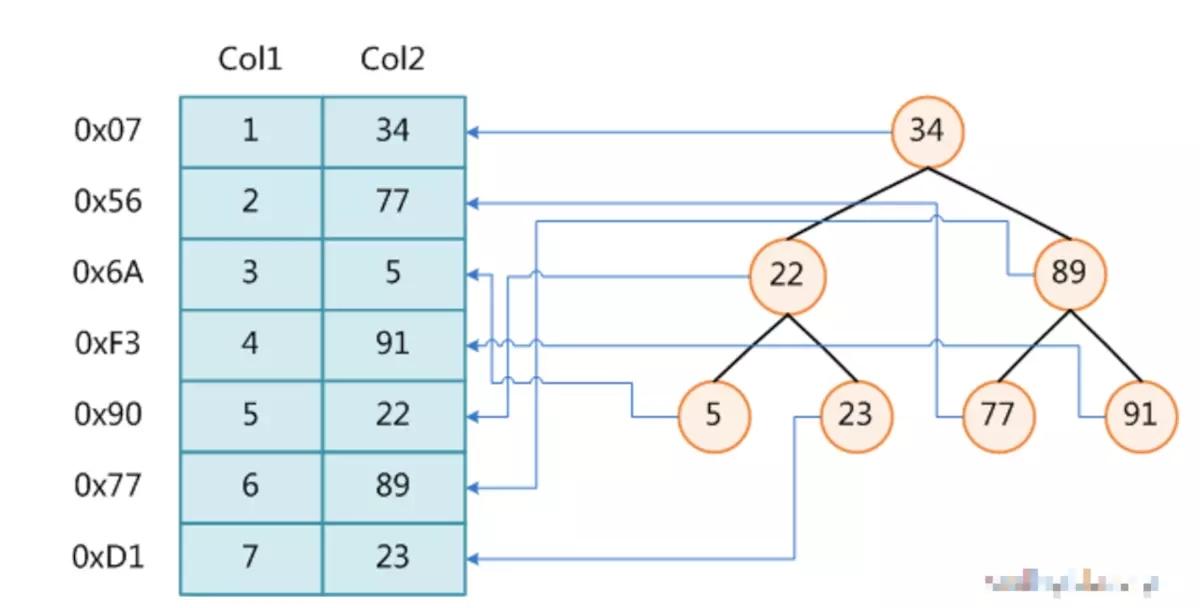
图1展示了一种可能的索引方式。左边是数据表,一共有两列七条记录,最左边的是数据记录的物理地址(注意逻辑上相邻的记录在磁盘上也并不是一定物理相邻的)。为了加快Col2的查找,可以维护一个右边所示的二叉查找树,每个节点分别包含索引键值和一个指向对应数据记录物理地址的指针,这样就可以运用二叉查找在O(log2n)的复杂度内获取到相应数据。
虽然这是一个货真价实的索引,但是实际的数据库系统几乎没有使用二叉查找树或其进化品种红黑树(red-black tree)实现的,原因会在下文介绍。
B-Tree和B+Tree
目前大部分数据库系统及文件系统都采用B-Tree或其变种B+Tree作为索引结构,在本文的下一节会结合存储器原理及计算机存取原理讨论为什么B-Tree和B+Tree在被如此广泛用于索引,这一节先单纯从数据结构角度描述它们。
B-Tree
是一种多路搜索树(并不是二叉的):
1.定义任意非叶子结点最多只有M个儿子;且M>2;
2.根结点的儿子数为[2, M];
3.除根结点以外的非叶子结点的儿子数为[M/2, M];
4.每个结点存放至少M/2-1(取上整)和至多M-1个关键字;(至少2个关键字)
5.非叶子结点的关键字个数=指向儿子的指针个数-1;
6.非叶子结点的关键字:K[1], K[2], …, K[M-1];且K[i] < K[i+1];
7.非叶子结点的指针:P[1], P[2], …, P[M];其中P[1]指向关键字小于K[1]的
子树,P[M]指向关键字大于K[M-1]的子树,其它P[i]指向关键字属于(K[i-1], K[i])的子树;
8.所有叶子结点位于同一层;
9.每个k对应一个data。
如:(M=3)相当于一个2–3树,2–3树是一个这样的一棵树, 它的每个节点要么有2个孩子和1个数据元素,要么有3个孩子和2个数据元素,叶子节点没有孩子,并且有1个或2个数据元素。

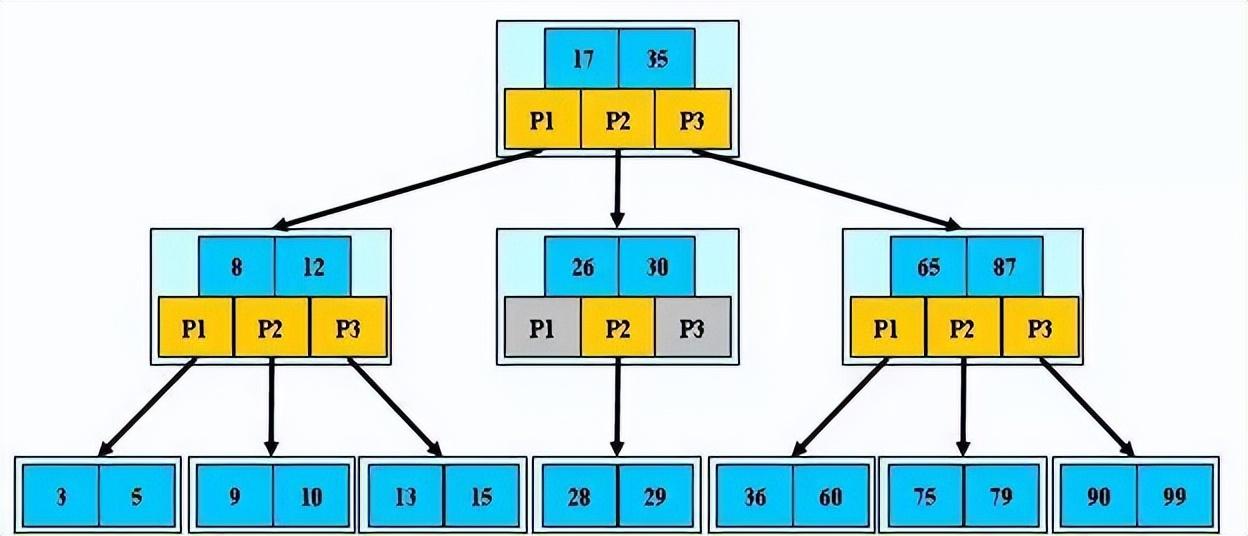
B-树的搜索,从根结点开始,对结点内的关键字(有序)序列进行二分查找,如果命中则结束,否则进入查询关键字所属范围的儿子结点;重复,直到所对应的儿子指针为空,或已经是叶子结点;B-Tree上查找算法的伪代码如下:
BTree_Search(node, key) { if(node == null) return null; foreach(node.key) { if(node.key[i] == key) return node.data[i]; if(node.key[i] > key) return BTree_Search(point[i]->node); } return BTree_Search(point[i+1]->node); } data = BTree_Search(root, my_key);B-树的特性:
1.关键字集合分布在整颗树中;
2.任何一个关键字出现且只出现在一个结点中;
3.搜索有可能在非叶子结点结束;
4.其搜索性能等价于在关键字全集内做一次二分查找;
5.自动层次控制;
B-树的自控制:
B树中每一个内部节点会包含一定数量的键值。通常,键值的数量被选定在d和2d之间。在实际中,键值占用了节点中大部分的空间。因数2将保证节点可以被拆分或组合。如果一个内部节点有2d个键值,那么添加一个键值给此节点的过程,将会拆分2d键值为2个d键值的节点,并把此键值添加给父节点。每一个拆分的节点需要最小数目的键值。相似地,如果一个内部节点和他的邻居两者都有d个键值,那么将通过它与邻居的合并来删除一个键值。删除此键值将导致此节点拥有d-1个键值;与邻居的合并则加上d个键值,再加上从邻居节点的父节点移来的一个键值。结果为完全填充的2d个键值。
B-树的构造过程:
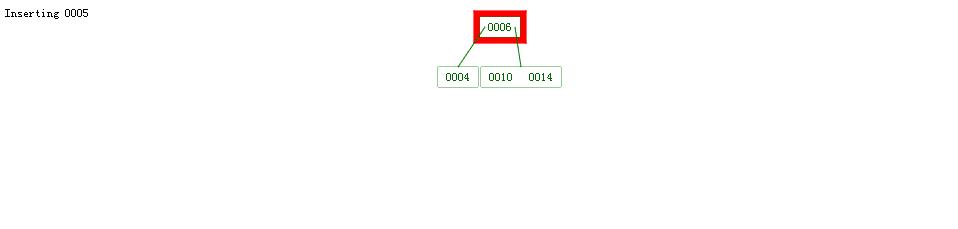
下面是往B树中依次插入
6 10 4 14 5 11 15 3 2 12 1 7 8 8 6 3 6 21 5 15 15 6 32 23 45 65 7 8 6 5 4

B+Tree
B-Tree有许多变种,其中最常见的是B+Tree,例如MySQL就普遍使用B+Tree实现其索引结构。
与B-Tree相比,B+Tree有以下不同点:
1.非叶子结点的子树指针与关键字个数相同;
2.非叶子结点的子树指针P[i],指向关键字值属于[K[i], K[i+1])的子树(B-树是开区间);
3.为所有叶子结点增加一个链指针;
4.所有关键字都在叶子结点出现;
5.内节点不存储data,只存储key
如:(M=3)

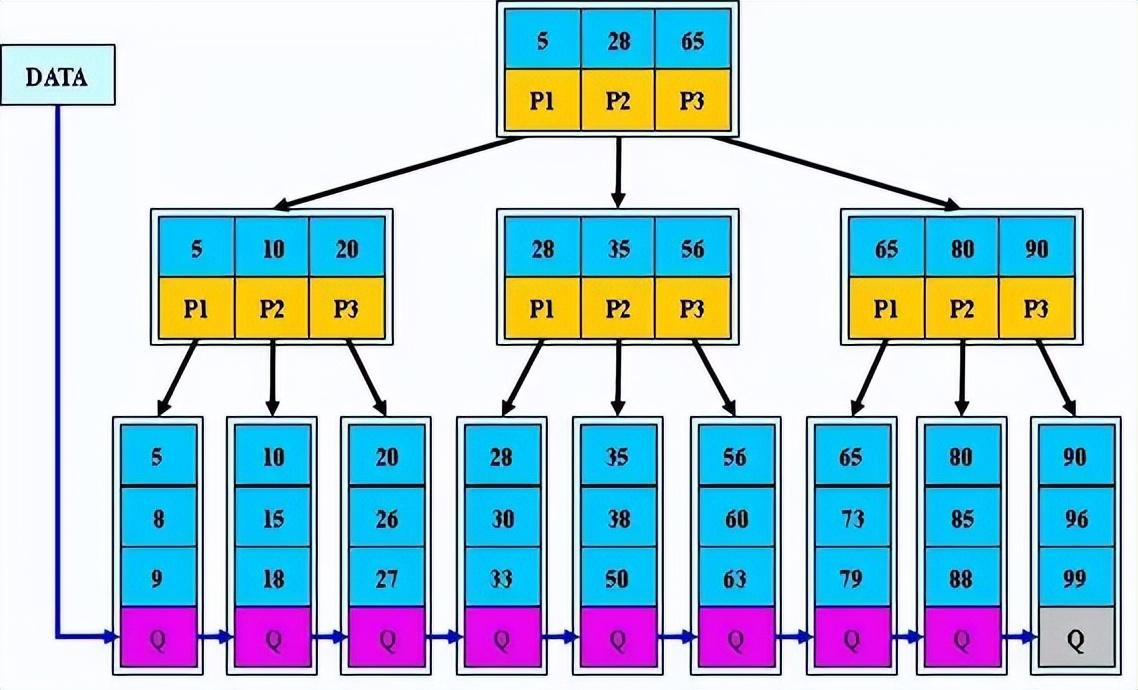
B+的搜索与B-树也基本相同,区别是B+树只有达到叶子结点才命中(B-树可以在非叶子结点命中),其性能也等价于在关键字全集做一次二分查找;
B+的特性:
1.所有关键字都出现在叶子结点的链表中(稠密索引),且链表中的关键字恰好是有序的;
2.不可能在非叶子结点命中;
3.非叶子结点相当于是叶子结点的索引(稀疏索引),叶子结点相当于是存储(关键字)数据的数据层;
4.更适合文件索引系统;
B+树的构造过程:
下面是往B+树中依次插入
6 10 4 14 5 11 15 3 2 12 1 7 8 8 6 3 6 21 5 15 15 6 32 23 45 65 7 8 6 5 4

索引的物理存储
一般来说,索引本身也很大,不可能全部存储在内存中,因此索引往往以索引文件的形式存储的磁盘上。这样的话,索引查找过程中就要产生磁盘I/O消耗,相对于内存存取,I/O存取的消耗要高几个数量级,所以评价一个数据结构作为索引的优劣最重要的指标就是在查找过程中磁盘I/O操作次数的渐进复杂度。换句话说,索引的结构组织要尽量减少查找过程中磁盘I/O的存取次数。
B-tree

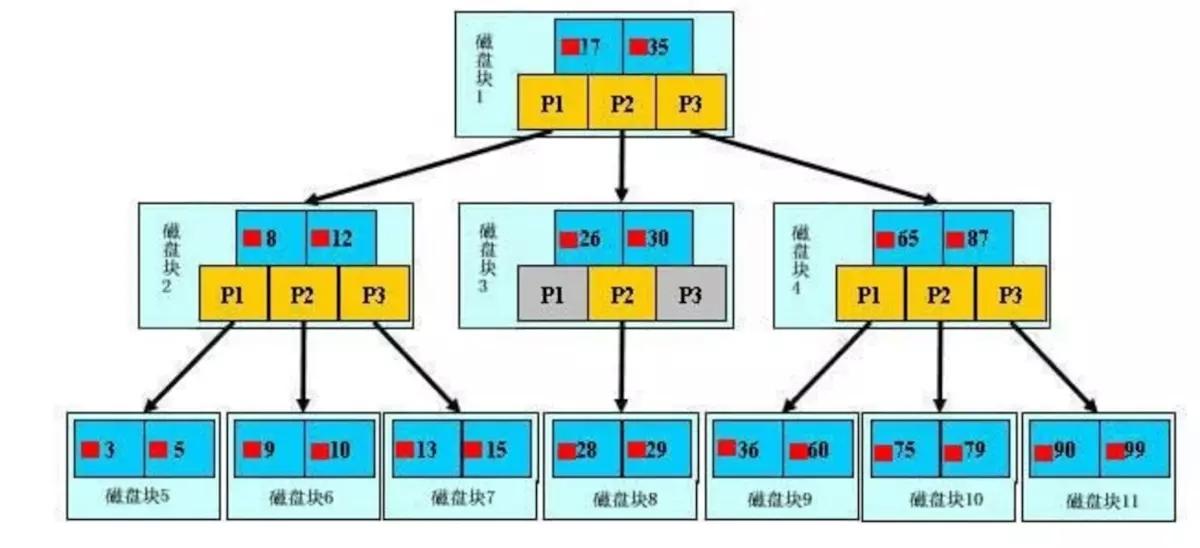
假如每个盘块可以正好存放一个B树的结点(正好存放2个文件名)。那么一个BTNODE结点就代表一个盘块,而子树指针就是存放另外一个盘块的地址。
下面,咱们来模拟下查找文件29的过程:
1.根据根结点指针找到文件目录的根磁盘块1,将其中的信息导入内存。【磁盘IO操作 1次】
2.此时内存中有两个文件名17、35和三个存储其他磁盘页面地址的数据。根据算法我们发现:17<29<35,因此我们找到指针p2。
3.根据p2指针,我们定位到磁盘块3,并将其中的信息导入内存。【磁盘IO操作 2次】
4.此时内存中有两个文件名26,30和三个存储其他磁盘页面地址的数据。根据算法我们发现:26<29<30,因此我们找到指针p2。
5.根据p2指针,我们定位到磁盘块8,并将其中的信息导入内存。【磁盘IO操作 3次】
6.此时内存中有两个文件名28,29。根据算法我们查找到文件名29,并定位了该文件内存的磁盘地址。
分析上面的过程,发现需要3次磁盘IO操作和3次内存查找操作。关于内存中的文件名查找,由于是一个有序表结构,可以利用折半查找提高效率。至于IO操作是影响整个B树查找效率的决定因素。
当然,如果我们使用平衡二叉树的磁盘存储结构来进行查找,磁盘4次,最多5次,而且文件越多,B树比平衡二叉树所用的磁盘IO操作次数将越少,效率也越高。
B+tree
B+tree的优点:
B+-tree的磁盘读写代价更低
****B+-tree****的内部结点并没有指向关键字具体信息的指针。因此其内部结点相对B 树更小。如果把所有同一内部结点的关键字存放在同一盘块中,那么盘块所能容纳的关键字数量也越多。一次性读入内存中的需要查找的关键字也就越多。相对来说IO读写次数也就降低了。
举个例子,假设磁盘中的一个盘块容纳16bytes,而一个关键字2bytes,一个关键字具体信息指针2bytes。一棵9阶B-tree(一个结点最多8个关键字)的内部结点需要2个盘快。而****B+
****树内部结点只需要1个盘快。当需要把内部结点读入内存中的时候,B 树就比****B+ ****树多一次盘块查找时间(在磁盘中就是盘片旋转的时间)。
B+-tree的查询效率更加稳定
由于非终结点并不是最终指向文件内容的结点,而只是叶子结点中关键字的索引。所以任何关键字的查找必须走一条从根结点到叶子结点的路。所有关键字查询的路径长度相同,导致每一个数据的查询效率相当。
mysql的两种存储引擎的索引存储机制
MyISAM索引实现
MyISAM引擎使用B+Tree作为索引结构,叶节点的data域存放的是数据记录的地址。下图是MyISAM索引的原理图:

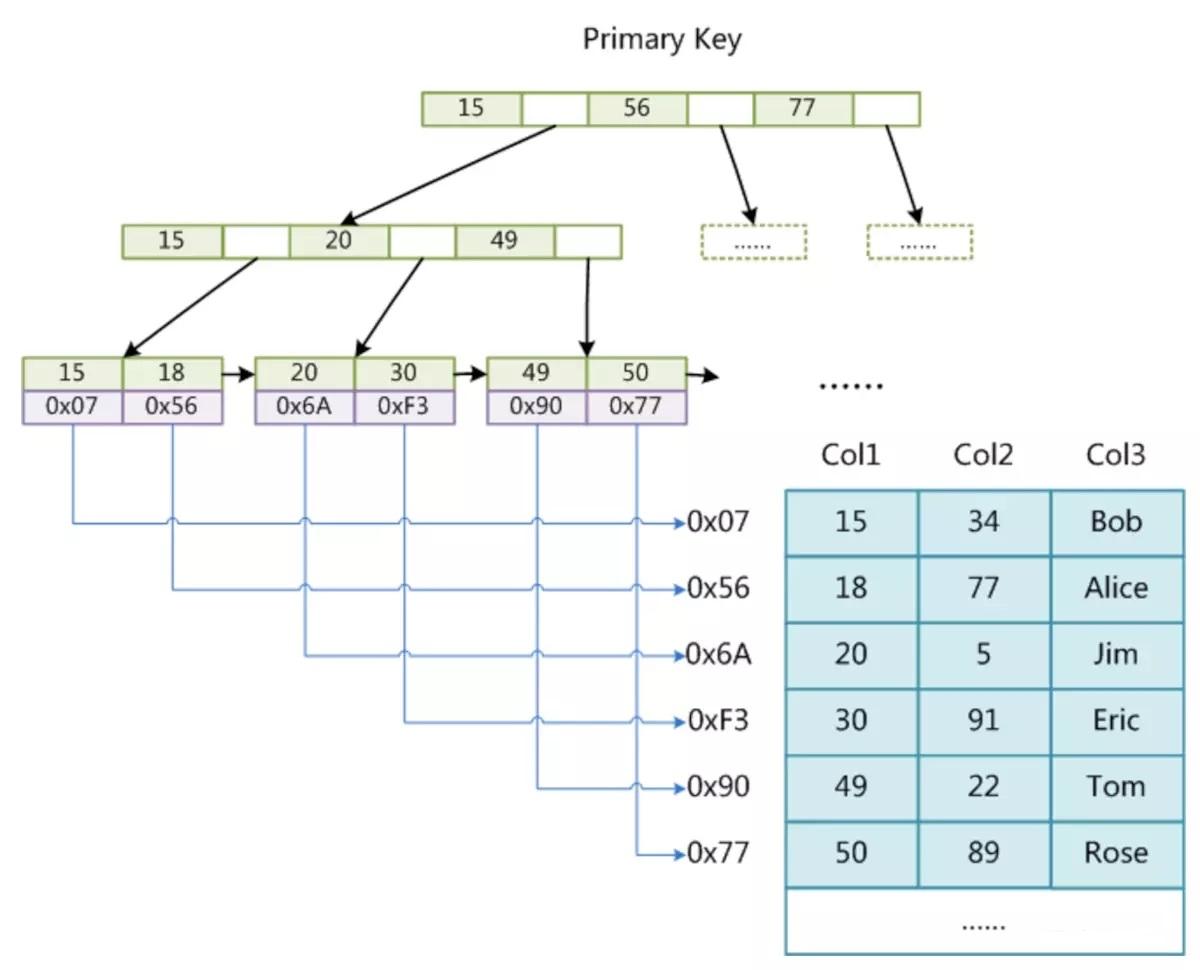
这里设表一共有三列,假设我们以Col1为主键,则上图是一个MyISAM表的主索引(Primary key)示意。可以看出MyISAM的索引文件仅仅保存数据记录的地址。在MyISAM中,主索引和辅助索引(Secondary key)在结构上没有任何区别,只是主索引要求key是唯一的,而辅助索引的key可以重复。如果我们在Col2上建立一个辅助索引,则此索引的结构如下图所示:

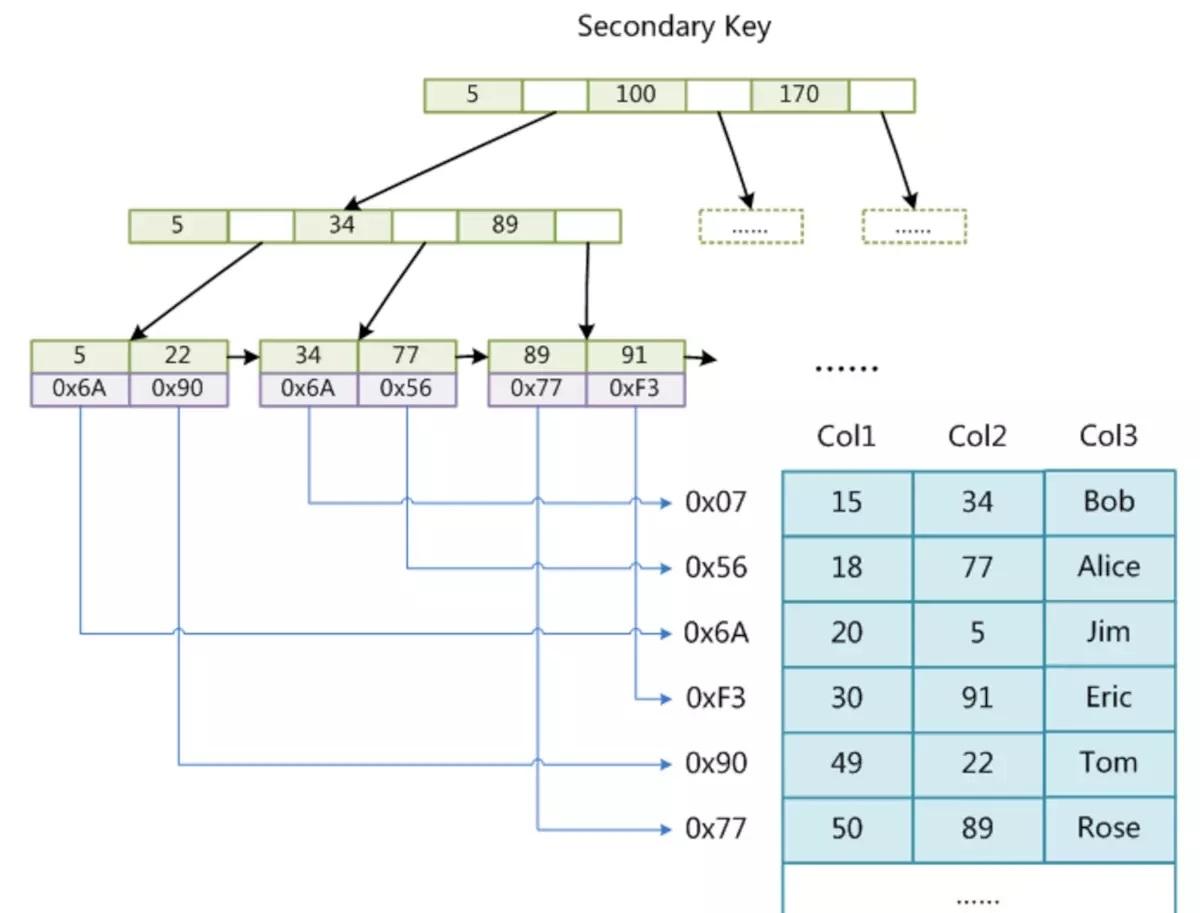
同样也是一颗B+Tree,data域保存数据记录的地址。因此,MyISAM中索引检索的算法为首先按照B+Tree搜索算法搜索索引,如果指定的Key存在,则取出其data域的值,然后以data域的值为地址,读取相应数据记录。
MyISAM的索引方式也叫做“非聚集”的。
InnoDB索引实现
虽然InnoDB也使用B+Tree作为索引结构,但具体实现方式却与MyISAM截然不同。
第一个重大区别是InnoDB的数据文件本身就是索引文件。从上文知道,MyISAM索引文件和数据文件是分离的,索引文件仅保存数据记录的地址。而在InnoDB中,表数据文件本身就是按B+Tree组织的一个索引结构,这棵树的叶节点data域保存了完整的数据记录。这个索引的key是数据表的主键,因此InnoDB表数据文件本身就是主索引。

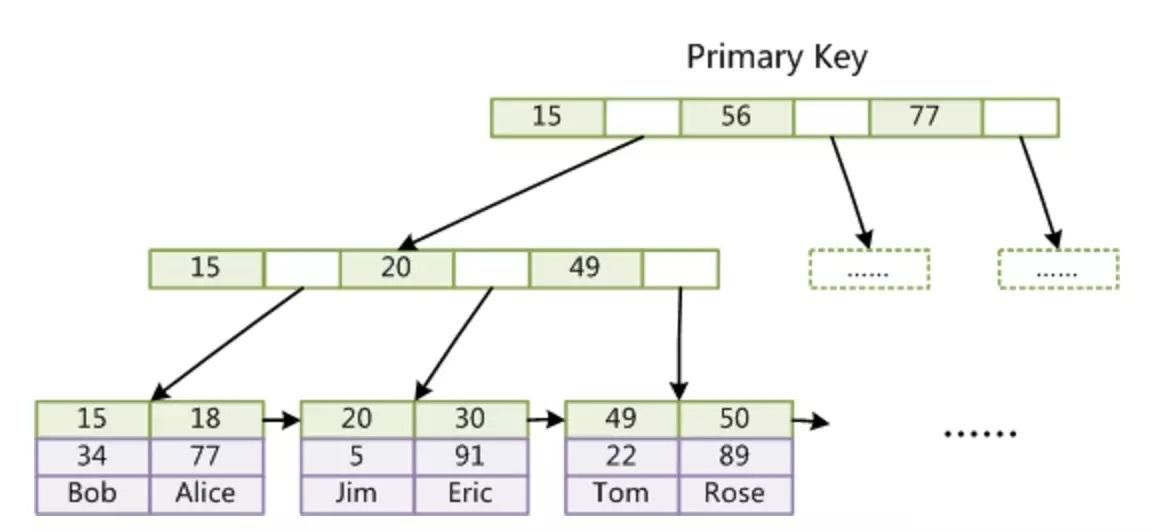
上图是InnoDB主索引(同时也是数据文件)的示意图,可以看到叶节点包含了完整的数据记录。这种索引叫做聚集索引。因为InnoDB的数据文件本身要按主键聚集,所以InnoDB要求表必须有主键(MyISAM可以没有),如果没有显式指定,则MySQL系统会自动选择一个可以唯一标识数据记录的列作为主键,如果不存在这种列,则MySQL自动为InnoDB表生成一个隐含字段作为主键,这个字段长度为6个字节,类型为长整形。
第二个与MyISAM索引的不同是InnoDB的辅助索引data域存储相应记录主键的值而不是地址。换句话说,InnoDB的所有辅助索引都引用主键作为data域。例如,定义在Col3上的一个辅助索引:

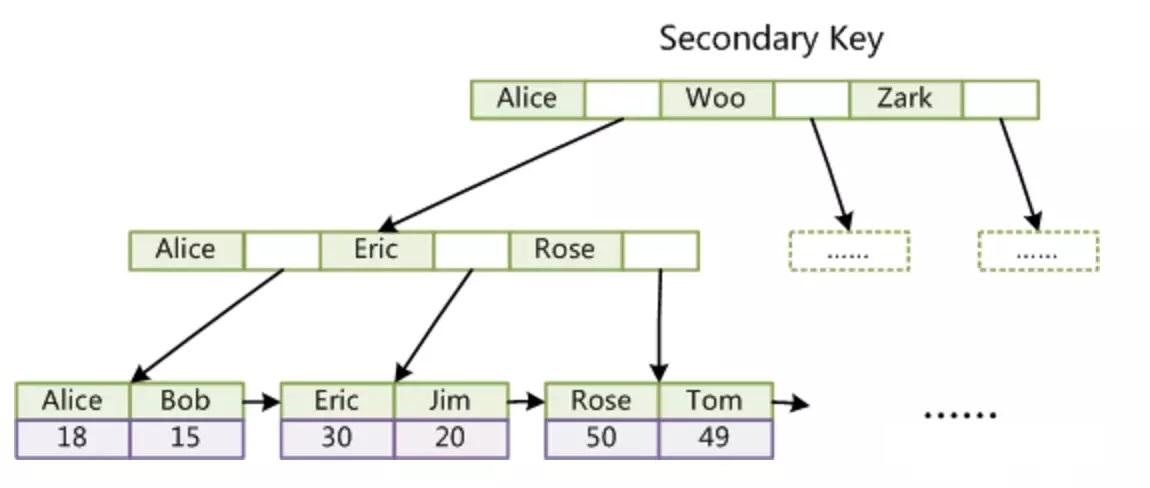
这里以英文字符的ASCII码作为比较准则。聚集索引这种实现方式使得按主键的搜索十分高效,但是辅助索引搜索需要检索两遍索引:首先检索辅助索引获得主键,然后用主键到主索引中检索获得记录。
了解不同存储引擎的索引实现方式对于正确使用和优化索引都非常有帮助,例如知道了InnoDB的索引实现后,就很容易明白为什么不建议使用过长的字段作为主键,因为所有辅助索引都引用主索引,过长的主索引会令辅助索引变得过大。再例如,用非单调的字段作为主键在InnoDB中不是个好主意,因为InnoDB数据文件本身是一颗B+Tree,非单调的主键会造成在插入新记录时数据文件为了维持B+Tree的特性而频繁的分裂调整,十分低效,而使用自增字段作为主键则是一个很好的选择。
最全的MySQL大表优化方案
当MySQL单表记录数过大时,增删改查性能都会急剧下降,可以参考以下步骤来优化:
单表优化
除非单表数据未来会一直不断上涨,否则不要一开始就考虑拆分,拆分会带来逻辑、部署、运维的各种复杂度,一般以整型值为主的表在千万级以下,字符串为主的表在五百万以下是没有太大问题的。而事实上很多时候MySQL单表的性能依然有不少优化空间,甚至能正常支撑千万级以上的数据量:
字段
尽量使用TINYINT、SMALLINT、MEDIUM_INT作为整数类型而非INT,如果非负则加上UNSIGNED
VARCHAR的长度只分配真正需要的空间
使用枚举或整数代替字符串类型
尽量使用TIMESTAMP而非DATETIME,
单表不要有太多字段,建议在20以内
避免使用NULL字段,很难查询优化且占用额外索引空间
用整型来存IP
索引
索引并不是越多越好,要根据查询有针对性的创建,考虑在WHERE和ORDER
BY命令上涉及的列建立索引,可根据EXPLAIN来查看是否用了索引还是全表扫描
应尽量避免在WHERE子句中对字段进行NULL值判断,否则将导致引擎放弃使用索引而进行全表扫描
值分布很稀少的字段不适合建索引,例如”性别”这种只有两三个值的字段
字符字段只建前缀索引
字符字段最好不要做主键
不用外键,由程序保证约束
尽量不用UNIQUE,由程序保证约束
使用多列索引时主意顺序和查询条件保持一致,同时删除不必要的单列索引
查询SQL
可通过开启慢查询日志来找出较慢的SQL
不做列运算:SELECT id WHERE age + 1 = 10,任何对列的操作都将导致表扫描,它包括数据库教程函数、计算表达式等等,查询时要尽可能将操作移至等号右边 sql语句尽可能简单:一条sql只能在一个cpu运算;大语句拆小语句,减少锁时间;一条大sql可以堵死整个库 不用SELECT *
OR改写成IN:OR的效率是n级别,IN的效率是log(n)级别,in的个数建议控制在200以内
不用函数和触发器,在应用程序实现
避免%xxx式查询
少用JOIN
使用同类型进行比较,比如用’123’和’123’比,123和123比
尽量避免在WHERE子句中使用 != 或 <> 操作符,否则将引擎放弃使用索引而进行全表扫描
对于连续数值,使用BETWEEN不用IN:SELECT id FROM t WHERE num BETWEEN 1 AND 5
列表数据不要拿全表,要使用LIMIT来分页,每页数量也不要太大
引擎
目前广泛使用的是MyISAM和InnoDB两种引擎:
MyISAM
MyISAM引擎是MySQL 5.1及之前版本的默认引擎,它的特点是:
不支持行锁,读取时对需要读到的所有表加锁,写入时则对表加排它锁
不支持事务
不支持外键
不支持崩溃后的安全恢复
在表有读取查询的同时,支持往表中插入新纪录
支持BLOB和TEXT的前500个字符索引,支持全文索引
支持延迟更新索引,极大提升写入性能
对于不会进行修改的表,支持压缩表,极大减少磁盘空间占用
InnoDB
InnoDB在MySQL 5.5后成为默认索引,它的特点是:
支持行锁,采用MVCC来支持高并发
支持事务
支持外键
支持崩溃后的安全恢复
不支持全文索引
总体来讲,MyISAM适合SELECT密集型的表,而InnoDB适合INSERT和UPDATE密集型的表
系统调优参数
可以使用下面几个工具来做基准测试:
sysbench:一个模块化,跨平台以及多线程的性能测试工具
iibench-mysql:基于 Java 的 MySQL/Percona/MariaDB 索引进行插入性能测试工具
tpcc-mysql:Percona开发的TPC-C测试工具
具体的调优参数内容较多,具体可参考官方文档,这里介绍一些比较重要的参数:
back_log:back_log值指出在MySQL暂时停止回答新请求之前的短时间内多少个请求可以被存在堆栈中。也就是说,如果MySql的连接数据达到max_connections时,新来的请求将会被存在堆栈中,以等待某一连接释放资源,该堆栈的数量即back_log,如果等待连接的数量超过back_log,将不被授予连接资源。可以从默认的50升至500
wait_timeout:数据库连接闲置时间,闲置连接会占用内存资源。可以从默认的8小时减到半小时
max_user_connection: 最大连接数,默认为0无上限,最好设一个合理上限
thread_concurrency:并发线程数,设为CPU核数的两倍
skip_name_resolve:禁止对外部连接进行DNS解析,消除DNS解析时间,但需要所有远程主机用IP访问
key_buffer_size:索引块的缓存大小,增加会提升索引处理速度,对MyISAM表性能影响最大。对于内存4G左右,可设为256M或384M,通过查询show status like ‘key_read%’,保证key_reads / key_read_requests在0.1%以下最好
innodb_buffer_pool_size:缓存数据块和索引块,对InnoDB表性能影响最大。通过查询show status like ‘Innodb_buffer_pool_read%’,保证 (
Innodb_buffer_pool_read_requests – Innodb_buffer_pool_reads) / Innodb_buffer_pool_read_requests越高越好
innodb_additional_mem_pool_size:InnoDB存储引擎用来存放数据字典信息以及一些内部数据结构的内存空间大小,当数据库对象非常多的时候,适当调整该参数的大小以确保所有数据都能存放在内存中提高访问效率,当过小的时候,MySQL会记录Warning信息到数据库的错误日志中,这时就需要该调整这个参数大小
innodb_log_buffer_size:InnoDB存储引擎的事务日志所使用的缓冲区,一般来说不建议超过32MB
query_cache_size:缓存MySQL中的ResultSet,也就是一条SQL语句执行的结果集,所以仅仅只能针对select语句。当某个表的数据有任何任何变化,都会导致所有引用了该表的select语句在Query Cache中的缓存数据失效。所以,当我们的数据变化非常频繁的情况下,使用Query Cache可能会得不偿失。根据命中率(Qcache_hits/(Qcache_hits+Qcache_inserts)*100))进行调整,一般不建议太大,256MB可能已经差不多了,大型的配置型静态数据可适当调大.
可以通过命令show status like ‘Qcache_%’查看目前系统Query catch使用大小
read_buffer_size:MySql读入缓冲区大小。对表进行顺序扫描的请求将分配一个读入缓冲区,MySql会为它分配一段内存缓冲区。如果对表的顺序扫描请求非常频繁,可以通过增加该变量值以及内存缓冲区大小提高其性能
sort_buffer_size:MySql执行排序使用的缓冲大小。如果想要增加ORDER BY的速度,首先看是否可以让MySQL使用索引而不是额外的排序阶段。如果不能,可以尝试增加sort_buffer_size变量的大小
read_rnd_buffer_size:MySql的随机读缓冲区大小。当按任意顺序读取行时(例如,按照排序顺序),将分配一个随机读缓存区。进行排序查询时,MySql会首先扫描一遍该缓冲,以避免磁盘搜索,提高查询速度,如果需要排序大量数据,可适当调高该值。但MySql会为每个客户连接发放该缓冲空间,所以应尽量适当设置该值,以避免内存开销过大。
record_buffer:每个进行一个顺序扫描的线程为其扫描的每张表分配这个大小的一个缓冲区。如果你做很多顺序扫描,可能想要增加该值
thread_cache_size:保存当前没有与连接关联但是准备为后面新的连接服务的线程,可以快速响应连接的线程请求而无需创建新的
table_cache:类似于thread_cache_size,但用来缓存表文件,对InnoDB效果不大,主要用于MyISAM
升级硬件
Scale up,这个不多说了,根据MySQL是CPU密集型还是I/O密集型,通过提升CPU和内存、使用SSD,都能显著提升MySQL性能
读写分离
也是目前常用的优化,从库读主库写,一般不要采用双主或多主引入很多复杂性,尽量采用文中的其他方案来提高性能。同时目前很多拆分的解决方案同时也兼顾考虑了读写分离
缓存
缓存可以发生在这些层次:
MySQL内部:在系统调优参数介绍了相关设置
数据访问层:比如MyBatis针对SQL语句做缓存,而Hibernate可以精确到单个记录,这里缓存的对象主要是持久化对象Persistence Object
应用服务层:这里可以通过编程手段对缓存做到更精准的控制和更多的实现策略,这里缓存的对象是数据传输对象Data Transfer Object
Web层:针对web页面做缓存
浏览器客户端:用户端的缓存
可以根据实际情况在一个层次或多个层次结合加入缓存。这里重点介绍下服务层的缓存实现,目前主要有两种方式:
直写式(Write Through):在数据写入数据库后,同时更新缓存,维持数据库与缓存的一致性。这也是当前大多数应用缓存框架如Spring Cache的工作方式。这种实现非常简单,同步好,但效率一般。
回写式(Write Back):当有数据要写入数据库时,只会更新缓存,然后异步批量的将缓存数据同步到数据库上。这种实现比较复杂,需要较多的应用逻辑,同时可能会产生数据库与缓存的不同步,但效率非常高。
表分区
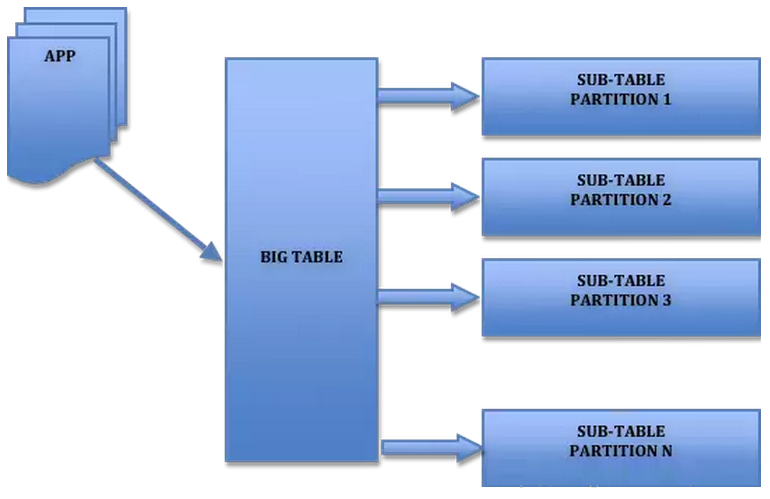
MySQL在5.1版引入的分区是一种简单的水平拆分,用户需要在建表的时候加上分区参数,对应用是透明的无需修改代码
对用户来说,分区表是一个独立的逻辑表,但是底层由多个物理子表组成,实现分区的代码实际上是通过对一组底层表的对象封装,但对SQL层来说是一个完全封装底层的黑盒子。MySQL实现分区的方式也意味着索引也是按照分区的子表定义,没有全局索引

mysql> explain partitions select count(1) from user_partition where id
in (1,2,3,4,5);
+----+-------------+--
| id | select_type | table | partitions | type |
possible_keys | key | key_len | ref | rows |
Extra |
+----+------------------
| 1 | SIMPLE | user_partition | p1,p4 | range | PRIMARY | PRIMARY | 8 |
NULL | 5 | Using where;
Using index |
+----+-------------------
分区的好处是:
可以让单表存储更多的数据
分区表的数据更容易维护,可以通过清楚整个分区批量删除大量数据,也可以增加新的分区来支持新插入的数据。另外,还可以对一个独立分区进行优化、检查、修复等操作
部分查询能够从查询条件确定只落在少数分区上,速度会很快
分区表的数据还可以分布在不同的物理设备上,从而搞笑利用多个硬件设备
可以使用分区表赖避免某些特殊瓶颈,例如InnoDB单个索引的互斥访问、ext3文件系统的inode锁竞争
可以备份和恢复单个分区
分区的限制和缺点:
一个表最多只能有1024个分区
如果分区字段中有主键或者唯一索引的列,那么所有主键列和唯一索引列都必须包含进来
分区表无法使用外键约束
NULL值会使分区过滤无效
所有分区必须使用相同的存储引擎
分区的类型:
RANGE分区:基于属于一个给定连续区间的列值,把多行分配给分区
LIST分区:类似于按RANGE分区,区别在于LIST分区是基于列值匹配一个离散值集合中的某个值来进行选择
HASH分区:基于用户定义的表达式的返回值来进行选择的分区,该表达式使用将要插入到表中的这些行的列值进行计算。这个函数可以包含MySQL中有效的、产生非负整数值的任何表达式
KEY分区:类似于按HASH分区,区别在于KEY分区只支持计算一列或多列,且MySQL服务器提供其自身的哈希函数。必须有一列或多列包含整数值
分区适合的场景有:
最适合的场景数据的时间序列性比较强,则可以按时间来分区,如下所示:
CREATE TABLE members (
firstname VARCHAR(25)
NOT NULL, lastname VARCHAR(25)
NOT NULL, username VARCHAR(16)
NOT NULL, email VARCHAR(35),
joined DATE NOT NULL )
PARTITION BY RANGE
( YEAR(joined) ) (