Python Requests.get访问网页403错误
Pycharm 2018.1, Python 3.6, 通过Pycharm的File->Settings->Plugins搜索Requests安装上去。
import requests
r = requests.get(
'
https://
xueqiu.com/
'
)
print(r.status_code)
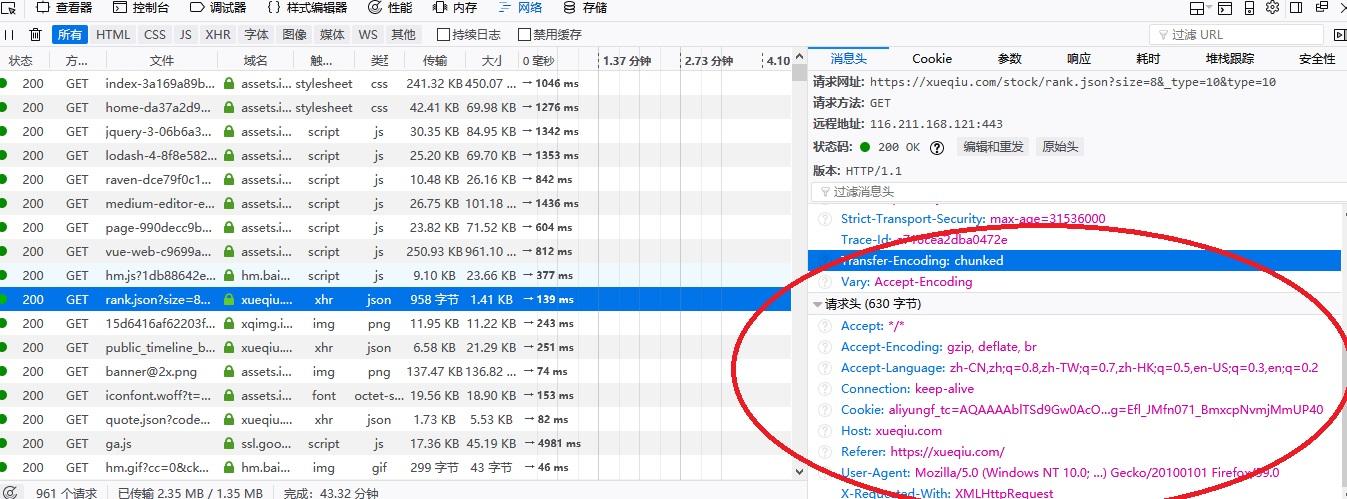
这段代码尝试访问雪球网站,结果会返回403错误代码表示forbidden。因为没加上http请求header,估计时雪球网站有一定的反爬虫策略。于是我构造了一个如下的header然后把header传递给get。
headers = {
'Accept'
:
'*/*'
,
'Accept-Encoding'
:
'gzip, deflate, br'
,
'Accept-Language'
:
'zh-CN,zh;q=0.8,zh-TW;q=0.7,zh-HK;q=0.5,en-US;q=0.3,en;q=0.2'
,
'Connection'
:
'keep-alive'
,
'host'
:
'xueqiu.com'
,
'Referer'
:
'https//
http://
xueqiu.com/
'
,
'User-agent'
:
'Mozilla/5.0 (Windows NT 10.0; WOW 64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36 QIHU 360SE'
}
r = requests.get(
'
https://
xueqiu.com/
',headers=headers
)
print(r.status_code)
这次访问返回200,表示访问成功。
注意,如果去掉User-agent访问将返回403,所以必须加上User-agent以模拟真实的浏览器访问。
一开始我从其他人的代码拷贝一个header过来用,按那个格式我把host行改为 ‘host': 'https// http:// xueqiu.com/ ', 结果访问返回400代码即格式有误。
如果不知道真实的http访问头是怎样的可以安装一个火狐浏览器,我安装了59版的,注意以前的著名的firebug已经停止开发了,不能用于比较新版的火狐了。于是我用按F12,捕捉浏览器的http消息,你就可以看到实际的请求header了。