with open(filename,"rb") as f:
for fLine in f:
测试结果:rb方式最快,100w行全遍历2.9秒。基本能满足中大型文件处理效率需求。如果从rb(二级制读取)读取改为r(读取模式),慢5-6倍。
内存检测工具介绍
memory_profiler
首先先用pip安装memory-profiler
pip install memory-profiler
memory-profiler是利用python的装饰器工作的,所以我们需要在进行测试的函数上添加装饰器。
from hashlib import sha1
import sys
@profile
def my_func():
sha1Obj = sha1()
with open(sys.argv[1], 'rb') as f:
while True:
buf = f.read(1024 * 1024)
if buf:
sha1Obj.update(buf)
else:
break
print(sha1Obj.hexdigest())
if __name__ == '__main__':
my_func()
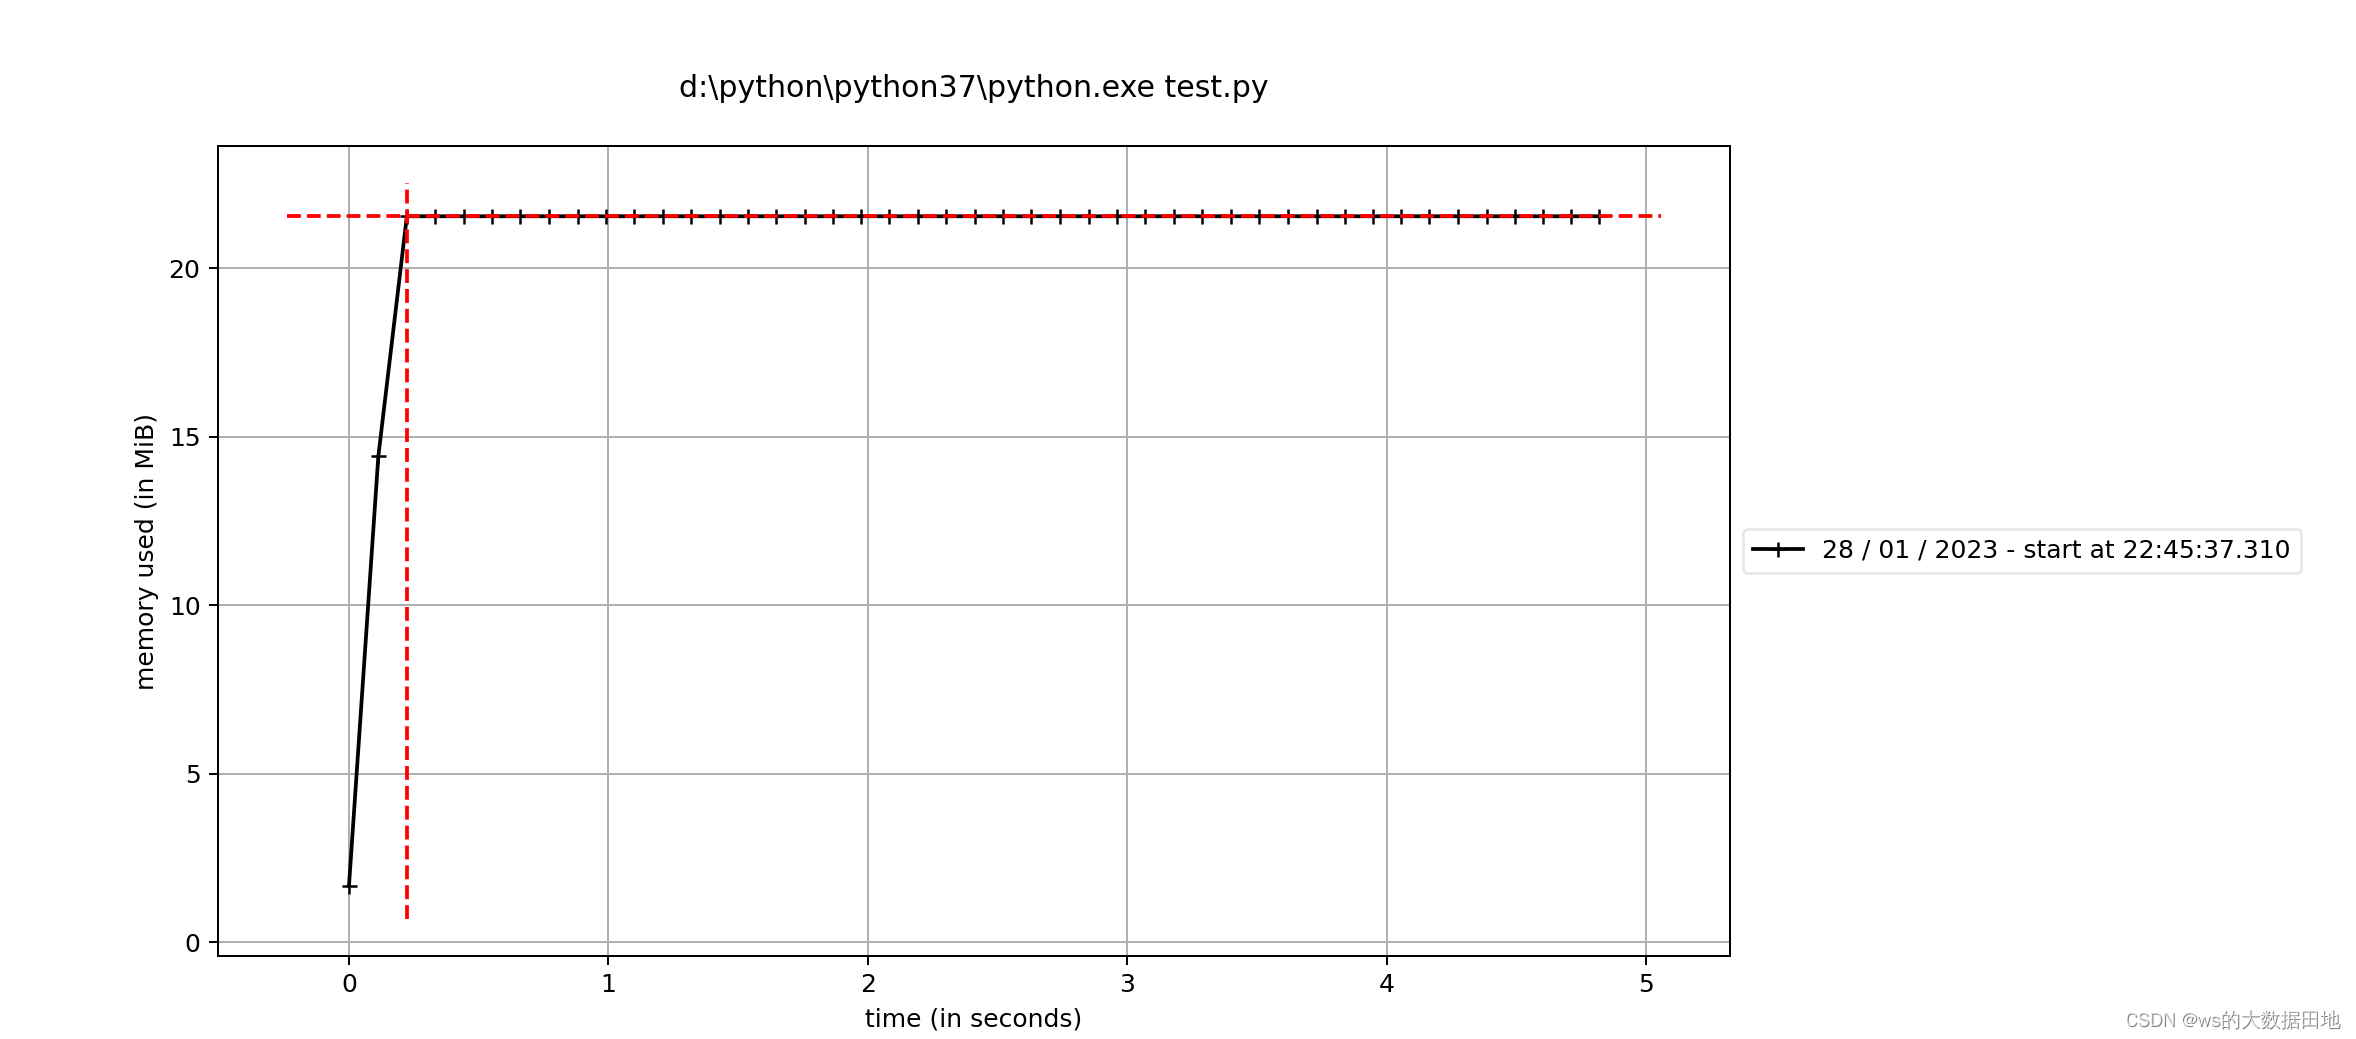
之后在运行代码时加上-m memory_profiler
就可以了解函数每一步代码的内存占用了。例如下图:
guppy
首先,通过pip先安装guppy3
pip install guppy3
之后可以在代码之中利用guppy直接打印出对应各种python类型(list、tuple、dict等)分别创建了多少对象,占用了多少内存。
from guppy import hpy
import sys
def my_func():
mem = hpy()
with open(sys.argv[1], 'rb') as f:
while True:
buf = f.read(10 * 1024 * 1024)
if buf:
print(mem.heap())
else:
break
通过上述两种工具guppy与memory-profiler可以很好地来监控python代码运行时的内存占用问题。
也可以使用mem_top或者pyrasite。有兴趣的可以看一下
最近处理文本文档时(文件约2GB大小),出现memoryError错误和文件读取太慢的问题,后来找到了两种比较快Large File Reading 的方法,本文将介绍这两种读取方法。
我们谈到“文本处理”时,我们通常是指处理的内容。Python 将文本文件的内容读入可以操作的字符串变量非常容易。文件对象提供了三个“读”方法...
f.read()
这种方法读取小文件,即读取大小远远小于内存的文件显然没有什么问题。但是如果是将一个10G大小的日志文件读取,即文件大小大于内存,这么处理就有问题了,会造成MemoryError … 也就是发生内存溢出。
这里发现跟re...
今天有个朋友问了我一个问题,如何使用Python读取大文件?觉得这个问题挺有意思的,就记录下来。
大部分时间我们处理小文件的时候(1g以内?),可以直接用f.read()或readlines()直接把全部内容读取到内存里面来。但当文件非常大,比如10g,100g的时候,文件的大小一般已经超出了机器的内存大小,就没法直接按小文件的方式处理了。那应该怎么办呢?
首先,选一个文件做演示,就用上一篇博客的...
之前使用pandas.read_csv()读取一个大文件,花了好长时间才读取完毕,但通过python的open函数打开时效率提高了好几倍。
python读取文件的一般方法:
file = open(res.FILE_PATH["shop"], 'r', encoding="gb18030")
# 读取一定量的文件
print(file.read(5))
# 查看文件格式
print(file)
# 逐行读取方法一
line = file.re
要在 Python 中读取 txt 文件,需要使用 Python 的内置函数 open() 和 read()。
首先,使用 open() 函数打开文件,并指定文件的路径和读取模式('r' 表示只读)。
f = open('test.txt', 'r')
然后,使用 read() 函数读取文件的内容。
content = f.read()
print(content)
最后,使用 close() 函数关闭文件。
f.close()
也可以使用 with 语句来打开文件,这样可以保证在文件使用完之后自动关闭文件。
with open('test.txt', 'r') as f:
content = f.read()
print(content)
在使用 read() 函数读取文件内容时,也可以使用 readlines() 函数来读取文件的每一行内容,并将每一行的内容存储在一个列表中。
with open('test.txt', 'r') as f:
lines = f.readlines()
print(lines)
在使用 readlines() 函数读取文件内容时,也可以使用 for 循环来逐行读取文件内容。
with open('test.txt', 'r') as f:
for line in f:
print(line)


