首篇基于Transformer的生成对抗网络综述2023:全面调研
一句话总结
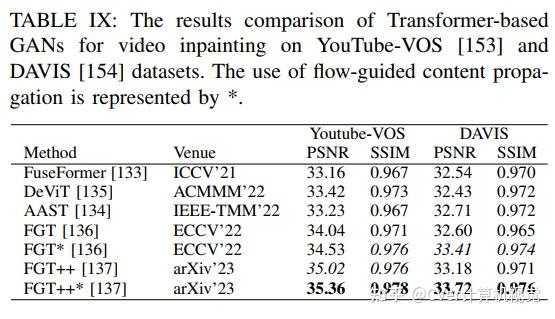
第一篇!18页综述,共计162篇参考文献!本文首次对计算机视觉应用中基于Transformer的生成对抗网络(GAN)的发展进行了全面调研,包含图像生成、图像转换、补全、图像恢复、重建、增强、视频生成和补全等方向,并进行了算法性能比较。
点击关注 @CVer计算机视觉 ,第一时间看到最优质、最前沿的CV、AI工作~
点击进入—> Transformer和GAN微信技术交流群


首篇基于Transformer的生成对抗网络综述2023
Transformer-based Generative Adversarial Networks in Computer Vision: A Comprehensive Survey
论文下载链接: https:// arxiv.org/abs/2302.0864 1
单位:IIIT
主要贡献

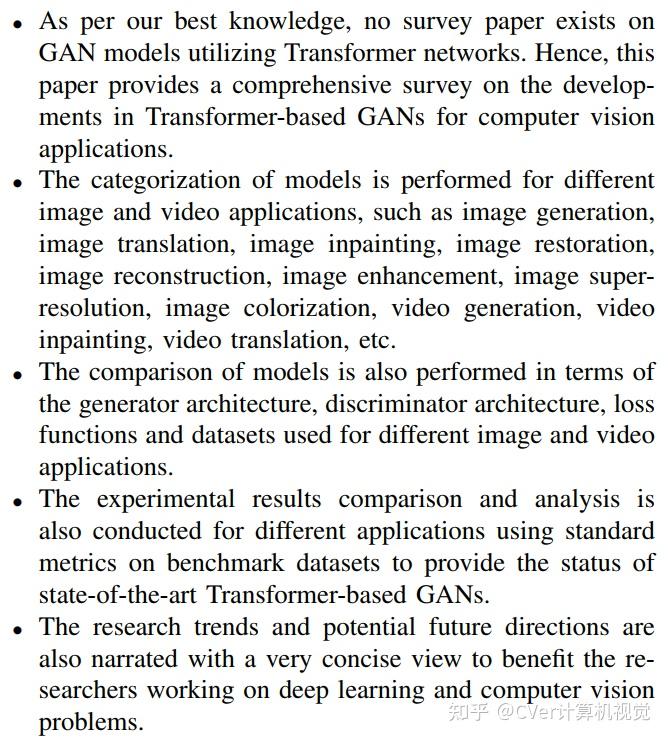
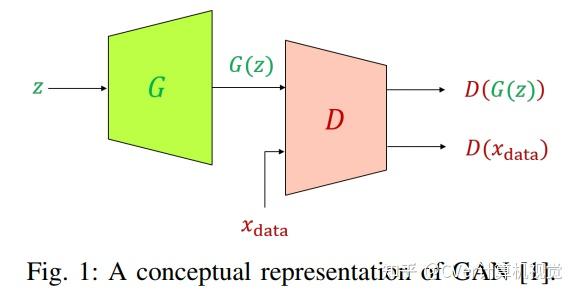
生成对抗网络(GAN)在合成给定数据集中的图像方面非常成功。GAN人工生成的图像非常逼真。GAN在一些计算机视觉应用中显示出潜在的可用性,包括图像生成、图像到图像转换、视频合成等。传统上,生成器网络是生成样本的GAN的主干,而鉴别器网络用于促进生成器网络的训练。鉴别器网络通常是卷积神经网络(CNN)。然而,生成器网络通常是用于图像生成的Up CNN或用于图像到图像转换的编码器-解码器网络。基于卷积的网络利用了层中的局部关系,这需要深度网络来提取抽象特征。因此,CNN难以利用特征空间中的全局关系。然而,最近开发的Transformer网络能够利用每一层的全局关系。

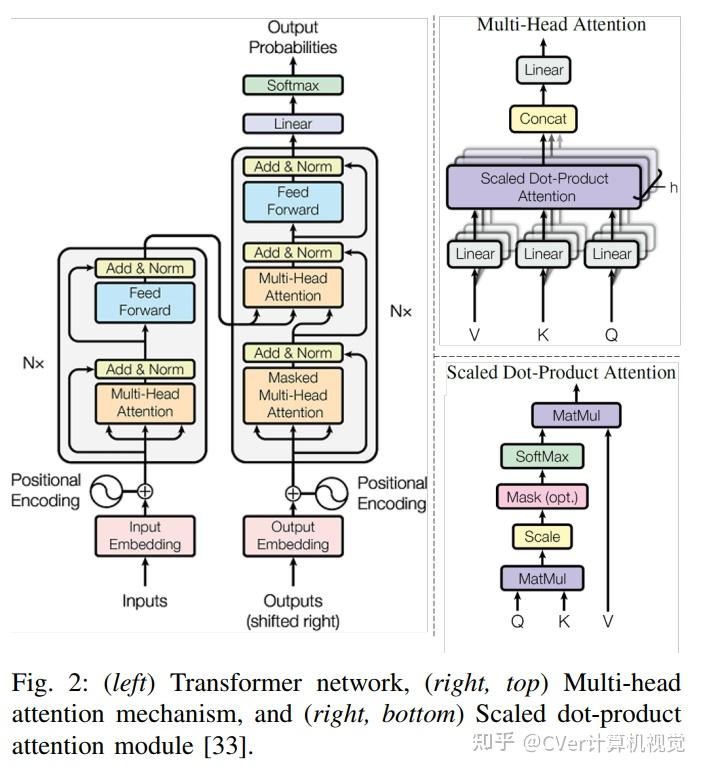
Transformer网络对计算机视觉中的几个问题表现出了巨大的性能改进。由于Transformer网络和GAN的成功,最近的工作试图利用GAN中的Transformer框架进行图像/视频合成。本文全面综述了将Transformer网络用于计算机视觉应用的GAN的发展和进步。
图像生成:

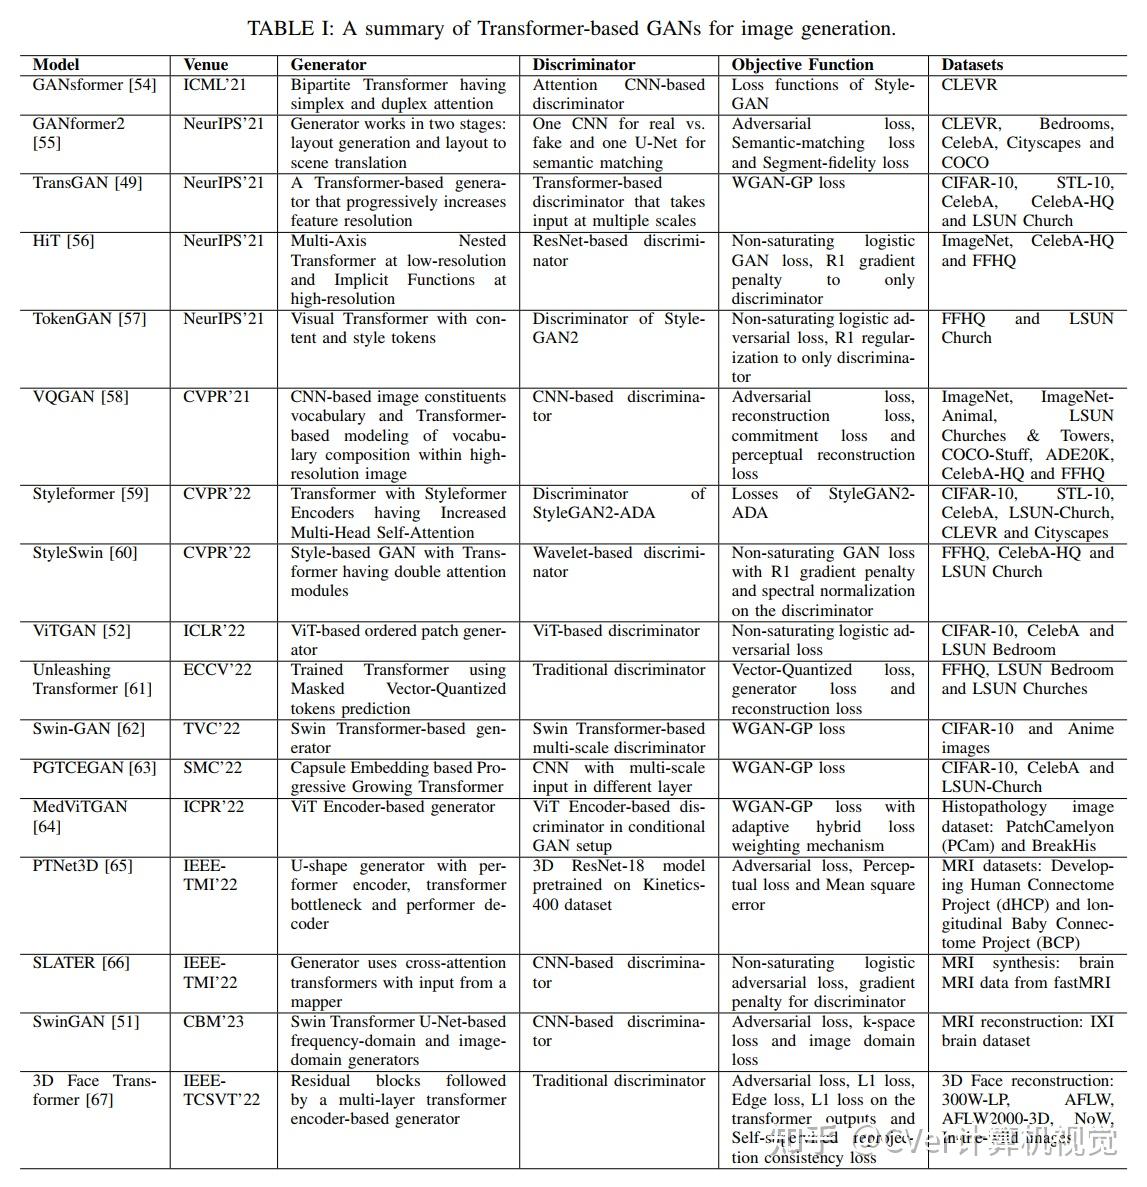
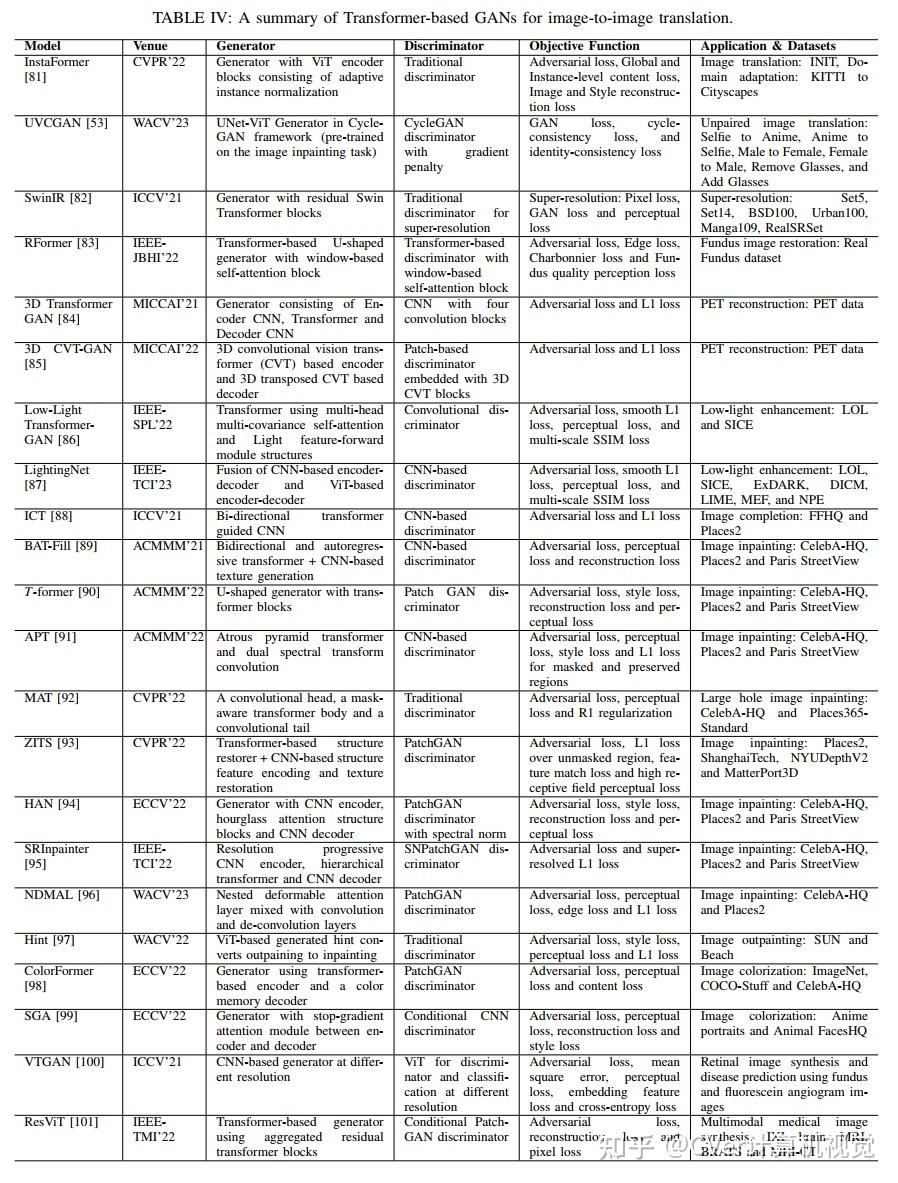
图像到图像转换:

视频应用:

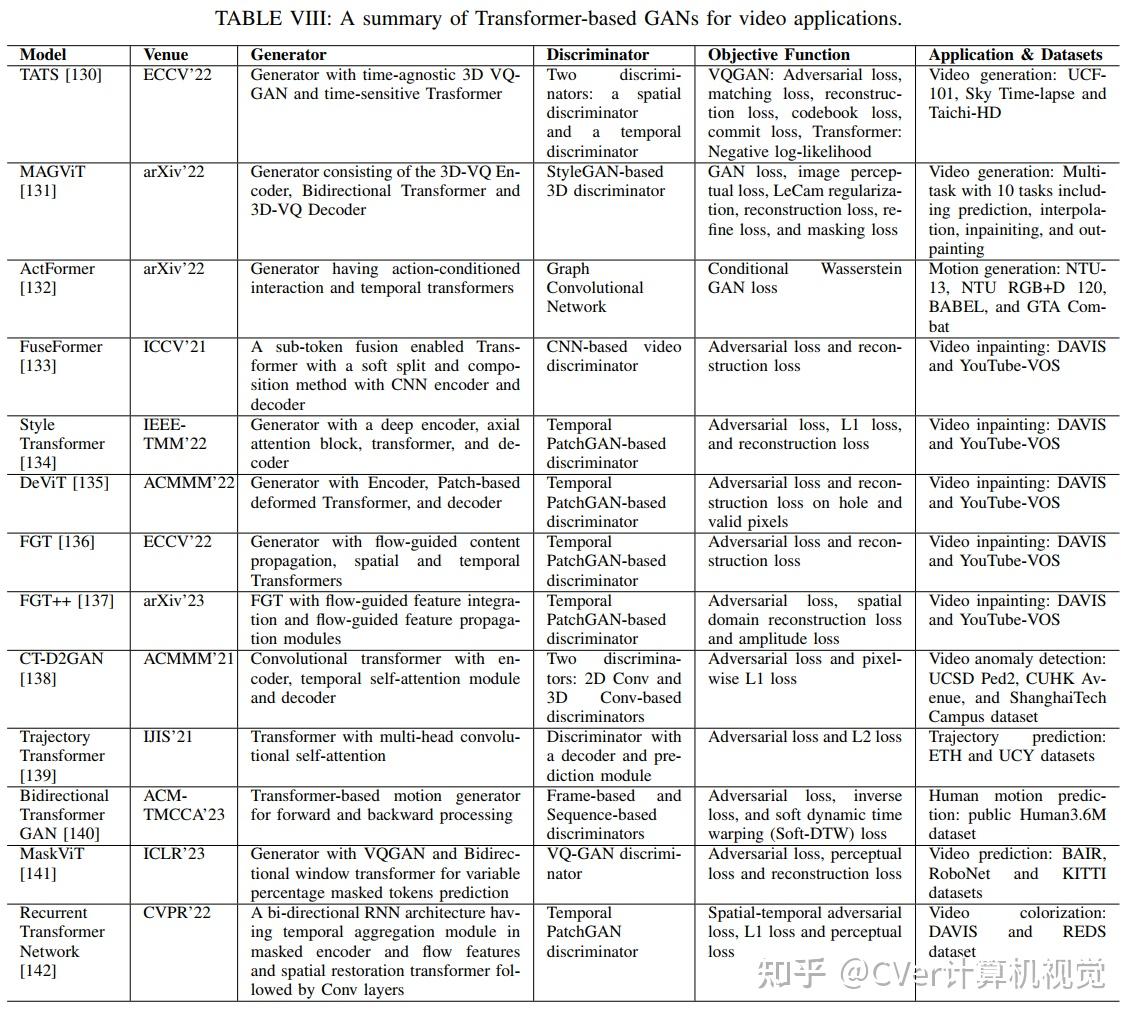
还对基准数据集上的几个应用的性能进行了比较和分析。

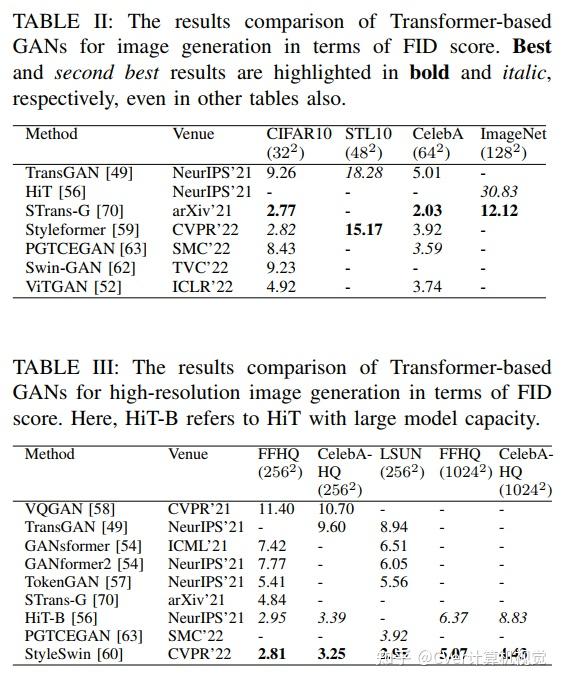

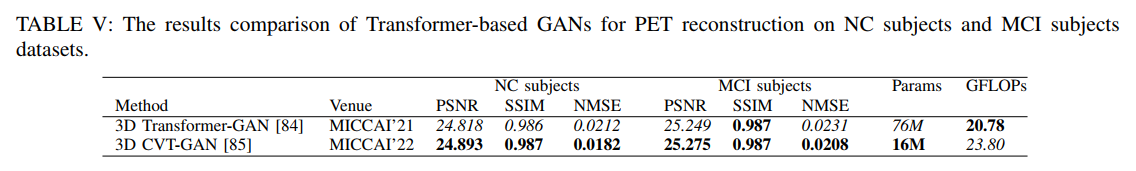

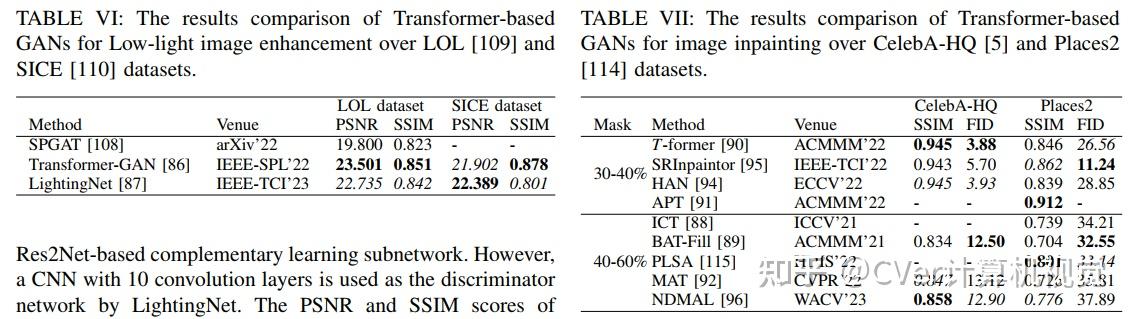

所进行的调研将非常有助于深度学习和计算机视觉社区了解与基于Transformer的GAN相关的研究趋势和差距,并通过利用不同应用的全局和局部关系开发先进的GAN架构。
点击进入—> Transformer和GAN微信技术交流群
CVer-Transformer交流群
建了CVer-Transformer交流群!想要进Transformer学习交流群的同学,可以直接加微信号: CVer222 。加的时候备注一下: Transformer+学校/公司+昵称+知乎 ,即可。然后就可以拉你进群了。
CVer-GAN交流群
建了CVer-GAN学习交流群!想要进GAN学习交流群的同学,可以直接加微信号: CVer222 。加的时候备注一下: GAN+学校/公司+昵称+知乎 ,即可。然后就可以拉你进群了。
推荐阅读
刷新91.1%准确率!谷歌重磅新作Lion:优化算法的符号发现
ChatCAD:基于大型语言模型的交互式计算机辅助医学图像诊断
谷歌新作ViT-22B:将视觉Transformer扩展到220亿参数
BLIP-2:使用冻结图像编码器和大型语言模型的语言-图像预训练
MedSegDiff-V2:基于Transformer和扩散模型的医学图像分割
ConvNeXt V2来了!使用MAE共同设计和扩展ConvNet
替换U-Net!DiT:基于Transformer的可扩展扩散模型
NMS(非极大值抑制)的反击!DETA:基于Transformer的新目标检测器
CCF论文列表(2022拟定)大更新!MICCAI空降B类!PRCV空降C类!ICLR继续陪跑...
65.4 AP刷新COCO目标检测新记录!InternImage:探索具有可变形卷积的大规模视觉基础模型
Sea和北大提出新优化器Adan:深度模型都能用!训练ViT和MAE减少一半计算量!